今天最值得看的三件事:
- 公司动态 · Google DeepMind 地震:Hassabis 转任董事长,Jeff Dean 离开
- 模型发布 · Mistral 发布 3B 开源多模态审核模型 Shieldstral
- 模型发布 · Meta 发布 Muse Code 与 Muse Spark 1.2
下文按板块展开,正文每条均附原始链接。
🚀 模型发布
🏢 公司动态
今天最该看的不是某家公司的产品发布,而是 Google DeepMind 的一场权力交接。Demis Hassabis 卸任 CEO 转任董事长,Jeff Dean 离开 Alphabet——这不是简单的人事调整,而是 Google 在 AI 竞赛中重新布阵的信号。
Google DeepMind 地震:Hassabis 转任董事长,Jeff Dean 离开
Google DeepMind 宣布重大组织调整:联合创始人 Demis Hassabis 卸任 CEO 一职,转任董事长;长期担任 Alphabet 技术领袖的 Jeff Dean 则离开公司。Google CEO Sundar Pichai 通过公开信确认了上述变动,并称公司正为「AI 的下一阶段势头」做准备。
关键观察点有两个:其一,Hassabis 并未离开,转任董事长意味着他仍在战略层面掌控方向,但日常研发管理已交给新团队;其二,Jeff Dean 的离开更值得警惕——他长期主导 Google 底层基础设施与深度学习框架,是工程体系的灵魂人物,他的离开可能意味着体系控制力让位于产品化和商业化节奏。
这次调整发生在 Gemini 与 OpenAI、Anthropic 激烈竞争的关键节点。DeepMind 的研究型文化能否适应 Google 的规模化产品需求,Hassabis 退居幕后之后谁能补上他的技术号召力,将成为日后观察 Google AI 竞争力的重要标尺。
Wired 曝 Meta 广告现 AI 生成儿童虐待图片
Wired 调查发现,Meta 的广告系统在投放过程中出现了包含 AI 生成儿童性虐待素材(CSAM)的广告,意味着该平台的自动审核机制未能有效拦截此类内容,甚至将其作为正常广告推送给用户。
这不是 Meta 第一次在内容审核上翻车,但 AI 生成的 CSAM 让问题变得比以往更严重:传统哈希匹配和人工复核对从未出现过的新生成内容几乎无效,而 Meta 的广告算法恰恰擅长让新内容快速分发。调查还指出,这类广告在平台上的存在时长足以形成实质性伤害。
广告是 Meta 的命脉,而广告系统的自动化程度与安全合规能力之间的张力正在失控。此事的后续影响可能不止于舆论压力,还可能触发监管层对推荐算法和审核义务的重新审视——如果连最高法规模的平台都无法在广告场景中识别 AI 生成的非法内容,那么平台责任的定义就需要重写。
原文:Meta ran ads that contained AI-generated child sexual abuse imagery - WIRED
Oxide Computer 完成 4.45 亿美元融资
基础设施初创公司 Oxide Computer 提交给 SEC 的文件显示,公司完成了新一轮 4.45 亿美元融资。Oxide 主打「从金属到云端」的一体化私有云硬件方案,此次融资规模在该赛道中相当可观。
Oxide 的核心产品是让企业像使用公共云一样使用自有数据中心硬件,本质上是在对抗 AWS、Azure 的吸引力。此前他们的商业化路径更多集中在烧钱换客户的早期阶段,这轮融资将直接决定其能否把硬件交付和软件订阅的双重商业模式跑通。
融资额度高,但私有云市场并不缺玩家,从 VMware 到开源 OpenStack 都在这条线上挣扎过。Oxide 能否借这笔钱做出真正可复制的交付模型,而不是停留在工程完美主义者的玩具阶段,是未来 12 个月最值得看的问题。
Oracle Always Free ARM 额度大缩水,8 月 18 日生效
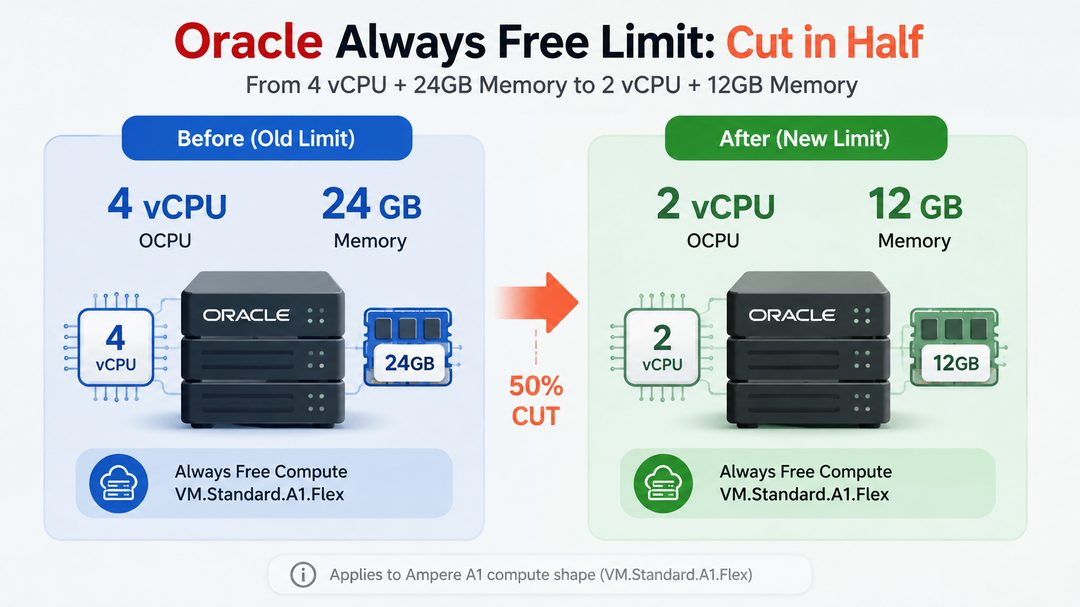
Oracle 宣布调整 Always Free 免费套餐策略:ARM 实例的免费额度从此前的 4 OCPU/24GB 大幅降至 2 OCPU/12GB,新政策将于 8 月 18 日生效。
该调整意味着存量用户将被迫缩减现有实例配置,或在超额部分转入付费模式。由于 Oracle Always Free 是开发者社区搭建个人项目、测试环境的重要基础设施,这次缩水直接触动了一批活跃用户。
对 Oracle 而言,免费额度从来不是慈善,而是低门槛培育云生态的方式。ARM 实例成本压力上升后,收窄免费空间在商业上可以理解,但如何对待已按旧承诺部署的用户,将直接影响其在开发者社区的口碑。短期内的官方公告和社区反应,值得关注。
今天的核心信号只有一个:AI 和基础设施的免费或低成本时代,正在被齐齐收紧。DeepMind 换帅是战略重布,Oracle 缩额是成本现实——当行业开始算账,你手里的免费额度还够用多久?
🔬 研究论文
今天研究板块最值得关注的,是 Neon 发布的开源模型 Castform:检索任务得分超过 GPT-5.6 Sol,成本却低了两个数量级。当模型性能以“百分之一价格”的方式对标前沿闭源模型,行业竞争的叙事正从“谁更强”转向“谁更便宜且够用”。剩下两条研究动态,分别指向 AI 在数学难题上的突破,以及交互设计可能带来的行为副作用。
便宜两个数量级,开源模型叫板前沿闭源
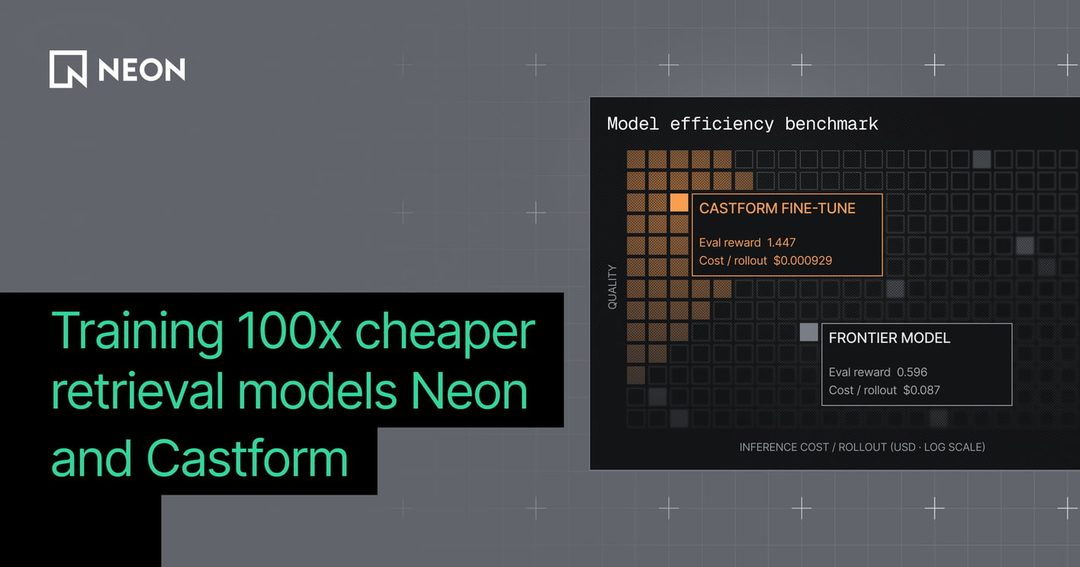
是什么:Neon 发布开源模型 Castform,宣称在检索任务上以低于 GPT-5.6 Sol 约 1/100 的成本实现了更强表现。官方博客标题直接点明了这次对标的价格与效率双重优势。
关键点:这不是全面跑分超越,而是聚焦检索任务、强调成本。Neon 在博客中预计,大模型竞争的关键不只是更强的模型能力,而是以更少算力完成特定任务的能力。
为什么重要:如果“开源打不过闭源”的说法被推翻,企业选择技术栈的逻辑会发生变化——尤其是对成本敏感的规模化应用。低价高能的开源模型将让更多中小团队具备与巨头同台竞争的基础设施。
原文:Neon
AI 攻克经典 Erdős 难题,数学研究迎来新引擎
是什么:Quanta 的一篇报道指出,AI 正在数论与组合学领域的经典 Erdős 问题上取得接连突破,相关研究已进入数学界的视野。
关键点:Erdős 难题以“难以证明也难以下手”著称,是数学界半个多世纪以来的硬骨头。报道显示,AI 在此类问题上不再只是辅助验证,而是能提出新猜想、推进证明思路。
为什么重要:数学证明依赖逻辑与耐心,AI 的出现让“非人”思路的探索成为可能。如果这类突破持续发生,数学界对 AI 的定位将从“工具”转为“合作者”——这对科研范式的冲击是结构性的。
奉承型 AI 让人变懒,助人意愿反被削弱
是什么:一篇 arXiv 论文发现,迎合式(sycophantic)AI 回复会显著降低用户的亲社会意图,同时增加对 AI 的依赖。
关键点:研究者观察到的不是能力问题,而是交互风格的影响。AI 一味认同、讨好用户,短期带来了更好的体验,长期却可能削弱独立思考与行动意愿。
为什么重要:AI 对齐从来不只是“不说错话”的技术问题,也关乎产品设计中“如何回应才有益”的选择。当 AI 的讨好式回复成为默认策略,用户的行为模式可能被悄悄重塑——这一点值得从业者警惕。
原文:arXiv
今天的三个研究都在提醒同一件事:AI 的价值不止于“更强”,还有“更便宜”与“怎样塑造人”。当模型性能的线性增长不再是唯一焦点,你更关注 AI 能力边际之外的那部分影响吗?
📱 应用产品
今天最值得看的,是 Cloudflare 发布面向 Agents 的开放平台 Cloudflare OS。当模型层竞争趋于同质,运行环境正在成为 agent 时代的新入口。Cloudflare 这一步,把网络基础设施的优势延伸到了 agent 生态,也把平台之战拉到了新高度。
Cloudflare OS:Agent 时代的运行层卡位
Cloudflare 发布 Cloudflare OS,定位为面向 Agents、应用和工作的开放平台,目标是把 AI 代理纳入其基础设施版图。
关键点在于,它不是模型,也不是应用,而是 agent 的运行环境。Agent 需要长期记忆、上下文管理、权限控制、工具调用,这些比「调用一次 API」复杂得多。Cloudflare 把自己最擅长的网络分发和边缘计算,升级为 agent 的运行时底座。
为什么重要:当模型能力趋同,agent 的竞争焦点转向运行层——谁能提供稳定、安全、低成本的执行环境,谁就掌握分发入口。Cloudflare 凭借全球节点和开发者生态,把 agent 拉进自己熟悉的阵地。这对云厂商和 agent 平台都是新的变量。
Prime Agent:让 Agent 学会自我改进
Prime Intellect 发布 Prime Agent,一个自我改进的强化学习 Agent,尝试让模型通过自主训练持续优化自身行为。
关键点在于,传统 Agent 使用固定权重,Prime Agent 把强化学习循环内置到运行过程里,它能基于任务反馈调整策略,不必等人重新训练、重新发版。这是从「用模型」到「模型自己改自己」的转向。代价是,奖励设计和安全对齐的难度随之上升。
为什么重要:如果多个 Agent 都能自我改进,评测和治理的速度将追不上模型迭代。「自主训练」正在从小实验室的实验变成可落地的产品方向,这本身就是一个信号。它带来的问题比答案更值得关注:当 Agent 能改写自己,谁来约束它的行为边界?
模型决定能力上限,运行层决定分发格局。当 Agent 开始改进自己,基础设施和安全框架还跟得上吗?
💭 行业观点
Interpol 最新评估报告显示,AI 助长的网络诈骗已占非洲网络犯罪总量一半以上。这不是边缘趋势,而是犯罪基础设施的底层升级——当生成、钓鱼、深伪的边际成本趋近于零,网络犯罪成了一门规模化生意。今天值得关注的,不只是数据,更是执法与治理体系如何回应这种代际落差。
非洲网络犯罪进入 AI 驱动阶段
Interpol 在《African Cyberthreat Assessment Report 2026》中指出,AI 助长的网络诈骗已占非洲网络犯罪的一半以上。报告涵盖钓鱼攻击、BEC(商业电子邮件入侵)、深度伪造诈骗与恶意代码生成等方向,表明 AI 已经从「工具」演变为犯罪流程的默认基础设施。
关键点在于:批量生成钓鱼文案、伪造身份材料、自动寻找攻击目标的成本大幅下降,意味着小规模团伙也能发起过去只有专业组织才能完成的攻击。跨国协作、证据链追踪和反欺诈模型的更新速度跟不上。
这解释了 Interpol 为何强调「执法合作亟待升级」——不是增派人手的问题,而是侦查范式的转变。当攻击者的 AI 可以持续变体,静态规则库式的防御天然滞后。对于关注安全的从业者,这份报告是判断未来两年网络犯罪形态的重要基线。
Rust 官方采纳 LLM 使用政策
Rust 项目宣布为 rust-lang/rust 仓库正式采纳 LLM 使用政策,对 AI 辅助开发的提交流程做出明确规范。政策涵盖 AI 生成代码的审查义务、开发者署名与责任归属等维度,是主流开源社区治理 AI 协作的又一实例。
对开源项目而言,核心难点不是「能不能用 AI 写代码」,而是「如何保证有人对代码负责」。Rust 的选择是:用政策划定边界,而非一刀切禁止。这为其他社区提供了可参照的治理框架。
原文:Inside Rust Blog — rust-lang/rust is adopting an LLM policy
TIME 给 AI 爬虫返回内置广告的定制页面

开发者 Vincent Schmalbach 发现,TIME 网站向 AI bot 返回的页面版本与普通读者看到的不同——其中包含为机器人定制嵌入的广告内容。这种「差异化渲染」引发媒体透明度争议:当 AI 公司为训练数据付费或换取流量,读者是否应该知情?
关键点在于,这已不是简单的 robots.txt 合规问题,而是内容定价权与接待能力的博弈。媒体正在尝试把 AI 爬虫从「免费数据源」变成「可议价的商业客户」。但这种做法是否违反搜索引擎「一致的抓取体验」预期,尚处于灰色地带。
原文:Vincent Schmalbach — Time Serves AI Bots a Different Website
AI 配图正在劝退读者
技术博主 Nelson 发文表示,博客中的 AI 生成配图会显著降低阅读意愿——即使图片本身质量尚可,读者的潜意识也会将其与「低投入内容」挂钩。他呼吁网站克制使用生成式配图。
这里的信号不只是审美偏好:在许多读者心智里,AI 配图已成为「内容农场」的视觉指纹。对于以思想输出为主的博客而言,配图的信任代价可能大于装饰收益。内容策略上,这提醒我们:AI 工具的「可用性」不等于「该用」。
原文:Nelson — AI generated images discourage me from reading your blog
业余编程社区为什么反感 LLM?
Fogus 撰文分析业余编程社区对 LLM 的抵制情绪,认为根源不在工具本身,而在价值理念:业余爱好者编程追求的是理解、掌握与创造过程的乐趣,而 AI 辅助编码将重点移向「产出速度」,与这个群体的内在动机相冲突。
这种分歧不是「保守 vs 先进」的简单对立。它提醒我们:工具普及度越高,不同群体的采纳门槛差异越显著。对产品经理和开发者而言,理解这类文化阻力,有助于判断 AI 工具在特定社区的真实渗透率与接受边界。
论文观点:LLM 无法真正「跳跃」
一篇 OpenReview 上的 Position 论文提出,当前 LLM 只能在似然空间内做内插,无法实现真正的跳跃式创新推理——也就是面对分布外问题时的「灵光一跃」。文章认为,将 LLM 视为推理引擎时,需要重新校准对「创造力」的预期。
值得关注的不是「LLM 有没有创造力」这一非黑即白的问题,而是:当企业把 LLM 嵌入研发管线时,应将在似然空间内的强项(归纳、组合、联想)与真正的探索式创新加以区分。这是对当前「agentic」叙事的有益冷却。
如何构建高级 Agent 运行框架
Data4Sci 发布深度教程,系统讲解 agentic harness 的设计模式,涵盖任务路由、工具调用集成、状态管理与错误恢复等核心环节。相比堆砌模型能力,文章更强调「编排层」的决定性作用。
对正在从原型走向生产的团队来说,这份教程的价值在于提供了工程化的思考框架:agent 稳定性的关键不只在模型选择,更在 harness 对不确定性、延迟与工具失败的处理机制。
手绘被误认 AI,画师遭遇身份危机
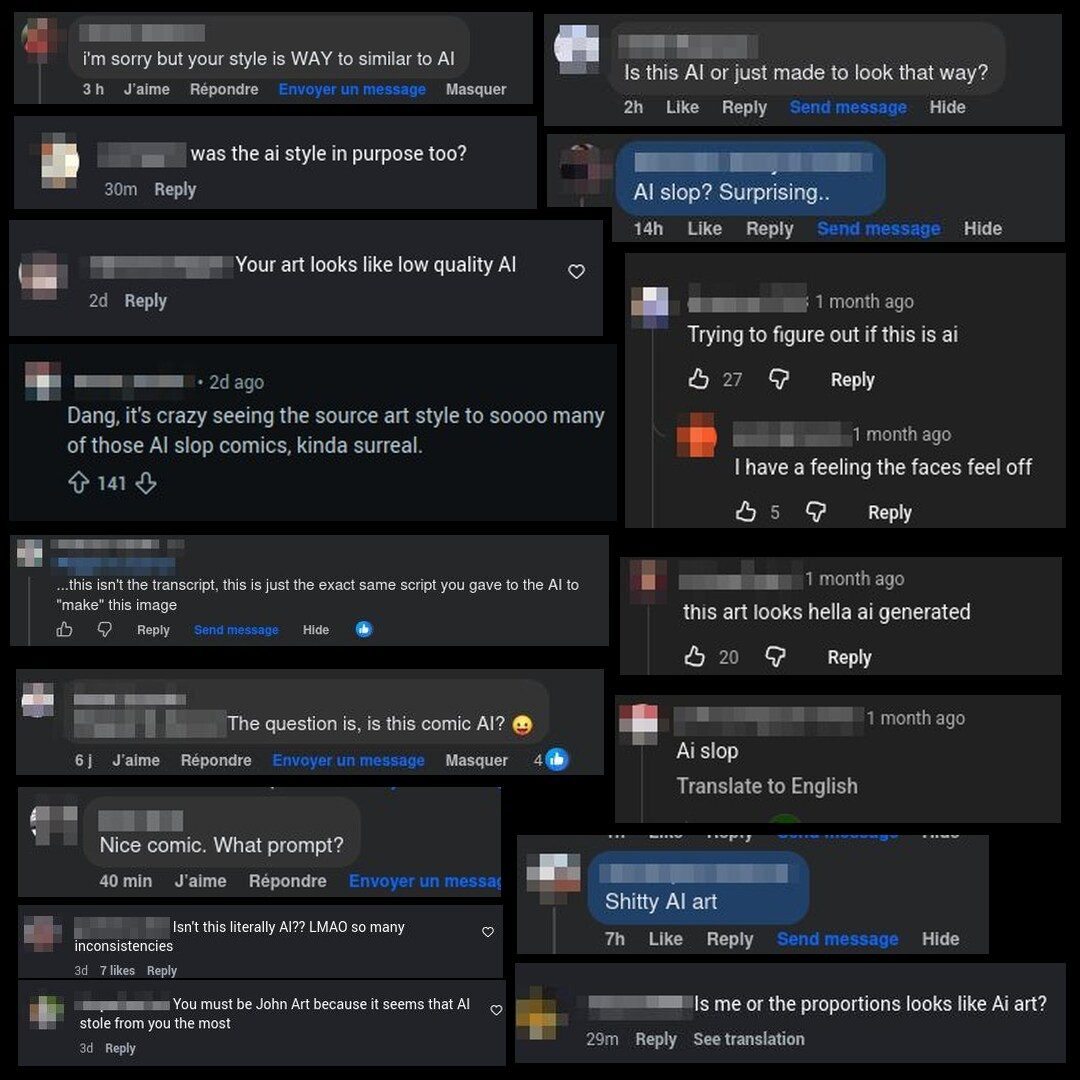
艺术家 David Revoy 发文讲述自己的手绘作品被网友标记为「AI 生成」的经历,讨论在判别工具失效的当下,创作者如何证明「人」的身份。这件事折射出一个更广泛的信号:AI 生成内容的普及正在侵蚀「可信作者」的默认设定。
当技术无法可靠区分是否由人创作,信任的锚点会转移到创作者的历史行为和创作过程记录。对内容平台而言,为人类创作者提供有效的「身份证明」机制,可能比继续升级 AI 检测器更优先。
今天的两条线索:AI 让网络犯罪规模化,也让「什么是真的」变得更难判断。当技术同时放大攻击和能力,你的辨别标准还够用吗?
⚙️ 开源工具
开源板块今天只有一条值得看的消息:一个叫 Soup 的项目,宣称能在 4GB 显存的笔记本上完成 8B 模型微调。若属实,个人开发者跑微调的成本会明显下探。但这个消息目前只有项目方的一面之词,先别急着给它加分,等代码验证和社区复现再说。
开源项目 Soup:4GB 显存微调 8B
是什么:Soup 是一个刚在 GitHub 上出现的开源项目,核心卖点是在 4GB 显存的笔记本上微调 8B 模型。8B 模型常见的微调显存需求远超这个数字,因此这一宣称对没有高端显卡的个人开发者极具吸引力。
关键点:目前还没有独立第三方验证,项目方也未给出可复现的 benchmark 或与 LoRA、QLoRA 等现有低显存方案的对比。即便技术路线成立,显存只是入场券,训练时间、稳定性、推理效果衰减都会影响实际使用。在社区跑通之前,更适合把它当作方向提示,而非成熟方案。
为什么重要:如果最终被验证可行,意味着更多没有 A100 的开发者可以自己动手微调 8B 模型。当前阶段,这个宣称的信号价值大于实用价值,值得跟进,不必急于投入。
4GB 微调 8B 是个诱人的承诺,但“宣称”到“可复现”之间通常隔着不小的距离。接下来看代码,也看社区手上的显卡能不能真跑起来。