今天最值得看的三件事:
- 模型发布 · DeepSeek V4 Pro 0813 上线,API 同步更新
- 模型发布 · xAI 发布 Grok 4.6,评测指数 61 分
- 研究论文 · 新研究展示从专有 LLM API 窃取推理链
下文按板块展开,正文每条均附原始链接。
🚀 模型发布
🏢 公司动态
🔬 研究论文
一份新研究展示如何从黑盒的专有 LLM API 中重建模型的内部推理过程,并把结果直接贴在网站上。这件事比AI多了“内省意识”或又多了个评测工具更值得看,因为它击中了大模型商业化的软肋:如果“思维链”可以被逆向还原,那么“保密推理”就只剩下账面上的意义。
从 API 响应里逆向出思维链
一项名为“Stealing Reasoning Traces”的研究声称,可以从未公开推理过程的专有 LLM API 中,重建模型内部的思维链(chain-of-thought)。研究者把这项技术称为一种“脑部扫描”,他们不仅还原了推理过程,还顺带质询了“思维链”本身——它究竟是模型的真实行为,还是我们为了解释模型而人为构造的叙事。
关键点:这不是针对某个模型的漏洞利用,而是利用模型输出本身的统计特征做逆向推断。你问得越多、回答越长,还原出的内部推理就越完整。研究还发现,越强大的模型,越容易在输出中暴露自己的思考轨迹,因为它们的推理路径更稳定、更可预测。
为什么重要:过去一年,OpenAI、Anthropic 等厂商把“隐藏推理链”当作产品护城河,理由是安全与竞争。这项研究相当于直接拆掉了这面墙。它的存在意味着,要么所有生产推理链的 API 都得重新设计输出协议,要么“保密推理”这个概念本身要重新定义。对监管者而言,这也意味着“模型是否在说谎”不再是不可验证的黑箱。
arXiv 论文:LLM 具备“内省觉察”能力
一篇署名 arXiv 的论文(编号 2601.01828)提出,大型语言模型在规模扩张后出现了一种“新兴的内省式觉察能力”——模型能识别出自己不知道什么,并据此调整回答策略。这项研究并未声称模型具有意识,但它的措辞已经足够在 Hacker News 上引发两派交锋。
关键点:实验通过让模型在回答前先“自评置信度”,再与实际答案正确率对比,发现大模型的自我评估准确性显著高于小模型。批评者认为,这不过是模型学会了引用“我不确定”“这超出我的知识范围”等高频表达,属于模式匹配,不是真正的觉察。而支持者则强调,即便只是模式匹配,模型也确实“学会”了在不确定时示弱——这在工程上是有用的。
为什么重要:这个结论的边界很微妙。它不代表模型有意识,但提示了一个被低估的事实:模型的能力曲线不是平滑上升的,而是会在某个规模后突然出现一些我们并未显式训练的行为。“内省”也许是下一个这样的行为。但也可能只是我们太渴望看见它了——这正是 HN 讨论区分裂的根源。
原文:Emergent Introspective Awareness in Large Language Models
Lean Eval:从“忠实度”切入对齐评估
Millennium Research 发布了一款名为 Lean Eval 的评估工具,切入角度是 Faithfulness(忠实度):模型生成的回答在多大程度上忠实于其自身的知识状态,而非盲目迎合用户或胡编乱造。工具页面直接放出了可交互的评测界面,可以即时看到不同模型在这项指标上的差异。
关键点:它不考核“答案对不对”,而是考核“模型是否知道自己不知道”。Lean Eval 通过设计诱导性问题和信息不足的问题,测量模型是承认局限,还是强行给出虚假的自信答复。这实质上把“诚实”变成了一个可量化的工程指标,而非哲学概念。
为什么重要:对齐(alignment)研究最难的部分不是让模型更强,而是让模型“可靠”。Lean Eval 的贡献不在于提出新理论,而在于把“忠实度”从口头概念变成了自动化评测工具。当这种度量标准开始被效仿,模型训练的目标函数里,可能就会第一次出现“诚实”的权重。
今天的三个故事凑在一起,刚好是安全、意识和诚信三个维度。它们都在问同一个问题:当模型能默诵自己的推理过程,我们是否还能分辨它的“自信”和它的“真实不确定”?
📱 应用产品
Grok 不再只是聊天框里的模型。xAI 今日发布 Grok Bot,把它封装成交互式机器人产品在 X 平台落地——模型公司竞争正在从基准分数转向产品入口,这是今日应用产品板块最值得追踪的信号。
Grok Bot:xAI 把模型做成了产品
xAI 发布 Grok Bot,将 Grok 模型封装为可交互的机器人产品,在 X 平台提供新入口。
关键点是产品形态的变化:Grok 此前以对话形式存在于 X 和独立 App 中,Grok Bot 则进一步把能力商品化、服务化,用户可以直接与机器人交互,而不必理解背后的模型调用逻辑。xAI 选择在 X 平台优先上线,说明其核心阵地依然绑定社交场景的大规模流量入口。
为什么重要:大模型公司普遍在「模型能力」和「产品体验」之间选边,xAI 这一动作表明它正在向前者之外的战场推进。机器人服务意味着更低的用户使用门槛,也意味着模型竞争力开始以产品完成度衡量而非单纯的基准分数。
Discovered Materials:智能体加速新材料发现
Discovered Materials 发布 AI 智能体,面向半导体等行业自动发现和设计新材料。
是什么:一个面向材料科学的 AI agent 产品,核心能力是替代传统试错式的研发流程,在半导体等对材料性能要求极高的行业中,自动生成候选材料方案并评估可行性。YC 背景的团队,选择的是高价值、长周期、强专业壁垒的垂直场景切入。
关键点:它不是通用科研助手,而是直接面向「发现新材料」这一具体任务设计的工具——这意味着它可能需要整合模拟、数据库检索、文献挖掘等多重能力,而非简单地调用大模型。
为什么重要:材料研发是半导体产业链的关键瓶颈之一,AI 智能体如果真能缩短发现周期,就有机会从工具上升到基础设施。但这个领域验证周期长,仍需观察实际落地案例。
Suzanne:自然语言直接生成可制造模型
Suzanne 是一款面向实体产品设计与制造的 AI 工具,将自然语言描述转化为可制造模型。
是什么:用户输入一段产品描述,Suzanne 生成可直接用于制造的三维模型——它跨过了传统 CAD 软件的复杂操作,把设计门槛大幅降低。这类工具面向的是工程师和产品设计师,而不是普通消费者。
关键点:难点不在生成「看起来像」的模型,而在生成「能造出来」的模型。可制造性意味着几何精度、材料约束、工艺适配都要被同时满足。
为什么重要:AI 生成内容正从数字世界走向物理世界。Suzanne 这类产品如果能稳定产出可制造的模型,会改变产品原型阶段的工作流,但距离替代专业 CAD 流程还有很长路。
原文:Suzanne 3D
Keet:AI 生成视频课程
YC S24 团队发布 Keet App,可针对任意主题自动生成短视频课程与互动游戏。
是什么:输入主题,Keet 自动生成一节短视频课程,并配上互动游戏来巩固学习效果。它在做的是内容生成——把教育内容的制作成本压缩到接近零。
关键点:任意主题意味着内容覆盖面广,但深度和准确性存疑。面向 C 端用户的轻量学习场景或许可行,替代专业教育内容的可能性不大。
为什么重要:教育是 AI 生成内容最容易被低估的应用场景之一。Keet 这类产品验证的是「低成本生成教育内容」的可行性,但留存和教学效果才是真正的考验。
原文:Keet
四条故事指向同一个趋势:AI 产品正在从「能对话」走向「能干活」。Grok 做服务化,Discovered Materials 做科研发现,Suzanne 做实体制造,Keet 做内容生成——真正的问题不再是模型能力,而是谁能让能力落地成可用的产品。
💭 行业观点
⚙️ 开源工具
Modular 今天正式发布 Mojo 1.0,这是该语言诞生以来最重要的一个版本节点。对 AI 基础设施开发者而言,Mojo 的稳定版意味着 Python 生态与高性能计算之间,终于有了一个值得认真评估的桥梁。
Mojo 编程语言发布 1.0 正式版
Modular 宣布 Mojo 1.0 正式可用。Mojo 是一种面向 AI 基础设施开发者的编程语言,设计上兼容 Python 语法,但底层编译为高性能机器码,目标是在保持 Python 生态易用性的同时,提供接近 C/C++ 和 CUDA 的执行效率。
1.0 版本的核心价值在于 API 稳定性和工具链完备性。此前 Mojo 处于快速迭代期,API 变动频繁,生产环境采用风险较高。现在语言规范、标准库和编译器行为已经冻结,Modular 同步提供了完整的文档、调试工具和 IDE 支持,降低了团队评估和试用的门槛。
Mojo 的定位很明确:不是要取代 Python,而是吃掉 AI 基础设施中那些 Python 性能不够、C++ 开发效率太低的中间地带。如果你所在的团队正在做推理引擎、数据处理管道或模型服务层,Mojo 1.0 值得放进技术选型的候选清单。但也要注意,Mojo 的生态和社区仍在早期,第三方库的丰富程度远不及 Python 和 Rust,这可能是实际落地时最大的阻力。
Woxi:用 Rust 重写 Wolfram 语言
Woxi 是一个用 Rust 实现的开源 Wolfram Language 解释器,附带类似 Mathematica 的 notebook GUI。项目已经公开发布,代码和文档均可在官网获取。
这个项目值得关注的点有两个:一是 Wolfram 语言本身闭源且授权费用昂贵,Woxi 提供了一个开源兼容层;二是实现方式选择了 Rust,这意味着内存安全和性能都有较好的基础保证。目前 Woxi 对 Wolfram 语言标准的覆盖程度尚不完全,适合作为学习工具或轻量替代方案,但如果你在跑重度符号计算或依赖 Wolfram 专有算法库,现阶段的 Woxi 还撑不起来。
对开源社区来说,这个项目更像是一个起点——用现代系统语言重写经典计算工具的可行性证明。后续如果 Woxi 的兼容性和性能持续提升,它有可能成为 Wolfram 生态之外的一个真正可用的替代品。目前值得观望,值得 Star。
原文:Woxi
教程:macOS 虚拟机 GPU 直通加速 llama.cpp
trycua 发布了一篇技术指南,演示如何在 Apple Silicon 的 macOS 虚拟机中启用 GPU 直通(GPU passthrough),从而显著提升 llama.cpp 的 LLM 推理性能。
GPU 直通通常与 Linux 和 PCIe 设备相关,Apple Silicon 的虚拟机此前受限于虚拟化层的 GPU 访问方式,性能和灵活性都打了折扣。这篇教程的实操价值在于:它给出了一条明确路径,让开发者可以在 macOS 虚拟机里跑出接近宿主机的推理速度。对于需要隔离环境、多版本测试或团队协作场景下跑本地模型的人来说,这解决了一个很实际的问题。
不过教程的适用范围有限——需要 Apple Silicon 硬件、合适的虚拟机软件版本,以及一定的配置耐心。它更适合已经熟悉虚拟化和 LLM 工具链的中高级开发者。如果你偶尔在 macOS 上跑 llama.cpp 并觉得速度不够,这篇指南值得花十分钟读完。
Hax:用 C 写的极简终端 AI 编程智能体
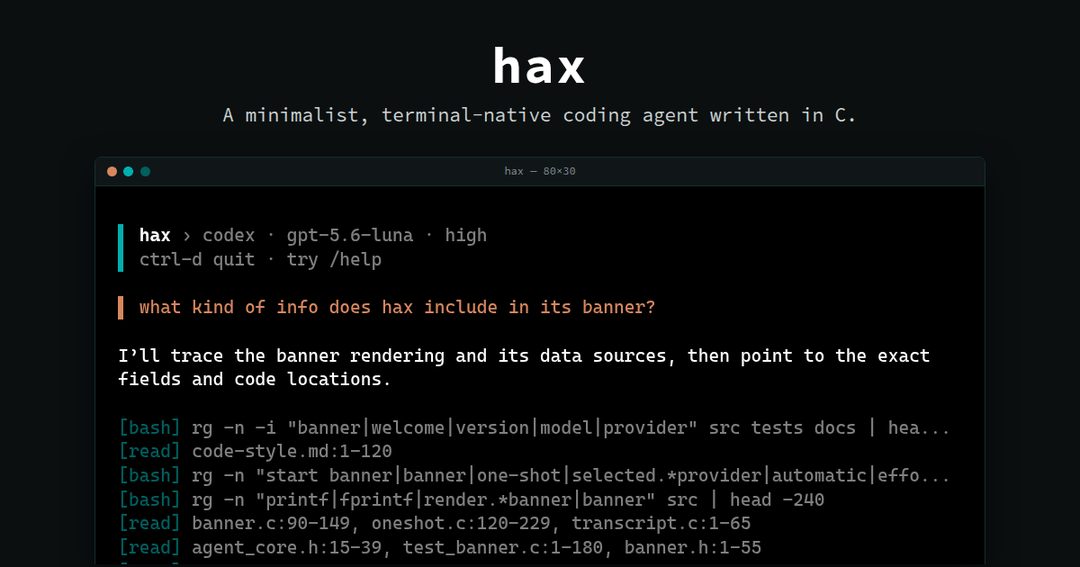
Hax 是一个用 C 语言实现的终端原生 coding agent,主打极简、低依赖和快速响应。项目已开源,官方页面展示了其基本用法和设计理念。
在大模型编程助手普遍走「重客户端 + 插件生态」路线的当下,Hax 走了另一个极端:一个 C 文件级别的单二进制,不依赖 Node.js 或 Python 运行时,启动即用。对于 SSH 到远端服务器、容器内开发或对系统资源敏感的场景,这种轻量方案有天然的吸引力。
Hax 的定位显然不是替代 Cursor 或 Copilot,而是服务于「快速、临时、终端内」的代码辅助需求。它的能力上限取决于底层调用的模型和 prompt 策略,C 实现的优势更多体现在启动速度和资源占用上。如果你对 agent 类工具的性能开销敏感,或者需要在没有图形界面的环境里干活,Hax 值得一试。
原文:Hax
Mojo 终于从「等它稳定」变成了「可以试用」,但真正的考验才刚刚开始。与此同时,Woxi 用 Rust 重新诠释 Wolfram,Hax 则用 C 语言的极简回应重客户端潮流——这两条支线或许都在提醒我们:语言生态的竞争,从来不只是性能之争。