今天最值得看的三件事:
- 模型发布 · 阿里开源Qwen3.8-27B,家用显卡可跑
- 模型发布 · Meta 发布开源权重模型 Glimmer
- 公司动态 · SpaceX 正式完成收购 Cursor
下文按板块展开,正文每条均附原始链接。
🚀 模型发布
导语:今天这个板块最值得看的不是某个旗舰型号的发布,而是阿里开源的 Qwen3.8-27B——原生多模态、Apache 2.0,量化后能在消费级显卡上跑,性能还宣称超过自家前代 Plus。放在 Meta 同天开源 Glimmer 的背景下,信号很清晰:开源模型正在逼近闭源商业模型的可用性边界,而闭源厂商已经开始用新一轮定价来应答。以下是按重要性排序的五条。
阿里开源 Qwen3.8-27B:家用显卡就能跑的大模型
阿里千问正式开源 Qwen3.8 系列,其中 27B 原生多模态稠密模型是当前的开源重点。它对外宣布在编程和办公场景超过前代 Plus,Apache 2.0 协议意味着可自由商用、修改和分发;量化之后,消费级显卡就能跑起來。千问全球下载量已超 30 亿次,这次开源的直接效果是:个人开发者和中小团队不需要再为调用 API 按 token 付费,而是可以选择自持模型——数据不出门,长期成本更可控。国产开源模型从”能跑”迈入”能用、好用”的阶段,恐怕是最值得关注的行业变量。
原文:The Decoder
Meta 开源 Glimmer:和自家闭源路线同时下注
Meta 发布可本地下载运行的开源权重模型 Glimmer,与它另一款封闭在 API 背后的 Muse Spark 形成了鲜明对照。一边开源权重拉拢开发者,一边用闭源产品做商业化,Meta 在”开放 AI”上显然不打算站队。TechCrunch 的标题问得很直接:扎克伯格真的相信 AI 属于每个人吗?这个问题放到 Glimmer 身上,答案更接近”商业策略”而非”信仰”。但无论如何,开源权重让外部研究者和中小团队有了更多选择,也让”开放 AI”的讨论从要不要开源,转向了什么样的模型值得开源。
原文:TechCrunch
Gemini 3.7 Flash 降价突袭:性价比成了新战场
DeepMind 新帅上任后的首个动作,是发布 Gemini 3.7 Flash。性能逼近旗舰型号,定价却大幅下调,InfoQ 评价为”重新划下性价比斩杀线”。Flash 这条产品线的意义在于:速度、成本和能力三者之间的平衡点,正在成为模型竞争的胜负手。对开发者而言,低价高性能意味着此前算不过账的 AI 应用,现在有了落地空间;对行业而言,头部闭源厂商主动降价,也是对开源阵营步步紧逼的一种回应。旗舰拼上限,Flash 拼渗透——下一阶段模型公司的商业模型,恐怕更多要靠推理规模而不是单价来撑。
原文:InfoQ 中文站
GLM-5.3 编程能力 +50%:不改底座也能挤出水份
智谱发布 GLM-5.3,底座模型没有更换,编程能力却提升了约 50%,还顺手发现了一个潜伏 40 年的老漏洞。它的意义在于:模型升级未必等于换底座,训练方法、数据配比和对齐手段的优化,同样能挤出大块能力增量。这让”换版本号等于换模型”的行业惯性受到了挑战。对使用者来说,编程能力是最容易被感知和验证的维度——这次提升是可量化的实用价值;至于那个被揪出的老漏洞,则更像是一次能力的意外展示,给技术实力做了一次便宜且可信的背书。
原文:雷锋网
音潮 API 免费开放:音乐生成也要卷了
国产 AI 音乐模型”音潮”宣布 API 限时免费开放,直接对标 SUNO,宣称要根治 AI 音乐的通病。音乐生成是垂直赛道里离钱很近的品类:SUNO 已经占据了用户心智,后来者想突破,最直接的入口就是 API 和开发者生态。限时免费本质上是获客手段,效果是否真的如宣传所说,还要等市场验证。但可以确定的是,AI 音乐赛道正在从”拼模型效果”进入”拼分发渠道”的阶段,而国产模型选择用开放接口来打第一仗,打法是务实的。
原文:量子位
结语:今天的胜负手不是参数表,而是两个词:开源和性价比。当”能自己跑的模型”成为常态,下一轮比的可能不是谁更强,而是谁能被更多人装进自己的产品里。
🏢 公司动态
今天公司动态里最值得看的一件事,是 SpaceX 正式完成对 AI 编程公司 Cursor 的收购。火箭公司吃掉 AI 编程明星,表面是跨界并购,实际上与英伟达同日披露的 210 亿美元 SpaceX 持股互为映照——AI 的竞争,已经从模型层延伸到资本与产业版图。以下是今日重点。
SpaceX 吞下 Cursor:火箭公司开始写代码
是什么:AI 编程明星公司 Cursor 正式成为 SpaceX 的一部分,这笔备受关注的收购尘埃落定。
关键点:Cursor 是 AI 编程赛道最受关注的产品之一,此前被市场视为独立开发者工具的代名词。交易完成意味着它的独立叙事结束,接下来将作为 SpaceX 的技术资产存在。
为什么重要:SpaceX 的软件需求与航天场景高度相关,AI 编程工具的内部化,能让它在代码生成与工程效率层面拥有自研能力。对开发者工具市场而言,一个头部项目被收编,也宣告独立 AI 编程公司的估值逻辑需要重新定价。
原文:TechCrunch
英伟达减持 OpenAI,转押 SpaceX 与英特尔
是什么:在投资者压力下,英伟达缩减了对 OpenAI 的押注,同时披露持有约 210 亿美元 SpaceX 股份和 300 亿美元英特尔股份。黄仁勋同步提出最高 25% 残值支持机制,安抚算力投资市场。
关键点:英伟达一边是 AI 算力的最大卖方,一边在重新调整自己的投资组合。减持 OpenAI、披露持有 SpaceX 与英特尔股份,说明它的资本半径正从模型公司向外延伸。
为什么重要:英伟达的资产负债表,某种程度上比任何一家 AI 公司的融资消息都更能说明行业风向。残值支持机制的出台,也反映出算力资产贬值已成为投资者真实担忧。
原文:The Decoder
谷歌肢解 DeepMind:布林亲自下场
是什么:谷歌开始将 DeepMind 数个团队划归总部,谢尔盖·布林亲自下场督战,组织架构迎来大调整。
关键点:这轮调整的对象不是普通业务部门,而是谷歌最核心的 AI 研究资产之一。团队划归总部,意味着 DeepMind 与谷歌产品体系之间的边界进一步模糊。
为什么重要:对 AI 行业而言,DeepMind 的演变方向是一个标志性样本:当顶级的 AGI 研究机构逐步嵌入商业公司总部,研究路线会被产品优先级重新定义。创始人亲自下场,则让这次调整有了足够的执行力度。
原文:量子位
OpenAI 与 Anthropic 开打价格战
是什么:面对中国 AI 厂商的竞争压力,OpenAI 和 Anthropic 相继推出更便宜的模型,美国两巨头之间爆发价格战。
关键点:价格战通常发生在市场份额争夺最激烈的阶段。两家公司同时降价,说明中国竞争对手正在重构全球大模型的定价逻辑。
为什么重要:模型能力竞赛进入后半场,价格成为开发者迁移的决定性因素。对下游应用层是利好,但对依赖模型收入的 AI 公司来说,价格战会加速行业分化。
原文:Ars Technica
Meta 离职潮失控:百万美元留人失败
是什么:Meta 遭遇人才流失潮,即使提供 100 万美元以上的留任股权也无法阻止员工离开。此前以 7 亿年薪挖来的人才余家辉,也已离职创业。
关键点:百万美元留任方案属于补救性手段,说明 Meta 内部动荡已经难以用激励策略对冲。人才宁可放弃高额股权也要离开,问题出在组织预期与管理方向。
为什么重要:AI 人才流动是竞争格局的前置指标。Meta 流失的顶级工程师,大概率会加入或创办下一批 AI 创业公司,这些力量将在未来两年显性化。
宇树科技暗盘报价达发行价 3 倍
是什么:宇树科技尚未上市,场外暗盘交易已悄然兴起,中介报价最高达发行价的 3 倍以上。
关键点:暗盘交易反映的是打新资金的预期博弈。3 倍溢价意味着市场对机器人赛道的定价,已经明显领先于公司基本面。
为什么重要:A 股打新套利生态正在被极致演绎,场外暗盘成为新的介入窗口。溢价越高,上市后的波动风险也越大。
原文:36氪
段永平、李录调仓:AI 信仰出现裂缝
是什么:段永平在二季度大幅减持英伟达和谷歌,李录则清仓多只美股并翻倍增持拼多多。两位价值派大佬用调仓表达了对 AI 股的态度。
关键点:减持不等于清仓,但方向明确:估值太高。段永平在收缩科技敞口,李录重新挑选标的,两者的动作都说明美股 AI 股的高估值正被重新审视。
为什么重要:价值投资大佬的动作通常滞后于趋势,但比散户更早定价风险。他们对 AI 股的集中减仓,值得作为市场情绪的参考信号。
原文:36氪
英伟达落子印尼:首个大学 AI 中心启动
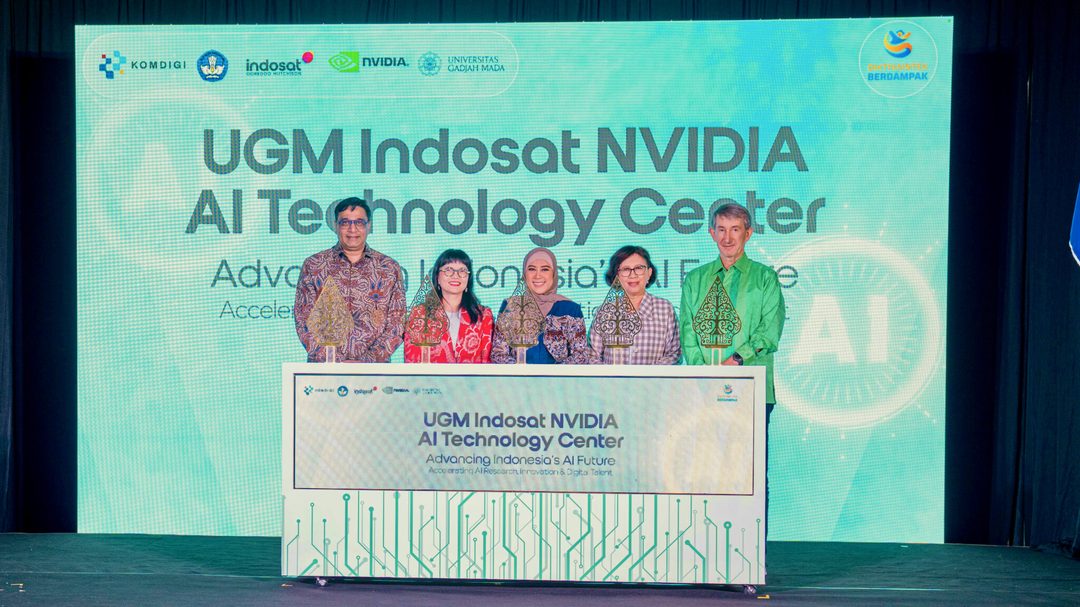
是什么:英伟达与印尼通信部、Indosat 和 Gadjah Mada 大学合作,在印尼开设全国首个大学 AI 技术中心,聚焦本地 AI 人才培养。
关键点:合作方横跨政府部门、电信运营商和高校,不是一次简单的设备捐赠,而是一个完整的本地化生态项目。
为什么重要:算力巨头的下一轮竞争,不是比谁芯片更强,而是比谁的开发者生态更深。英伟达在东南亚教育端的布点,是在为未来十年培育客户与人才池。
原文:NVIDIA Blog
AI 的战场已经不只是模型参数,还有股权与组织。下一个被收购或拆解的,又会是谁?
🔬 研究论文
今天的研究板块信息量不小,但我们建议你把目光放在两件事上:AI 的视觉感知被新 benchmark 确认拉胯,同时自主 AI 研究的说法也被研究打脸。一边是能力底座不牢,一边是路线叙事透支——这两条合在一起,才是当下 AI 的真实水位。至于同态加密、隐式推理、可解释性这类进展,可以放在这个坐标系里看:方向有意义,离成熟还早。
新基准确认 AI 视觉感知依然拉胯
最新 benchmark 测试显示,当前 AI 模型在视觉感知任务上表现依然糟糕,与人类水平差距明显。这不是某个具体模型的翻车,而是系统性的能力短板被量化确认。
关键点在于,视觉感知不是单纯的分类识别,而是对空间关系、细节变化、场景一致性的综合理解。这类任务长期被多模态模型的“口语回答”掩盖,日常对话里看不出问题,一旦落到具体指标上就原形毕露。
为什么重要:视觉感知是 agentic、具身智能、自动驾驶的共同底座。感知层不牢,上层规划和控制都是沙滩上的建筑。这项测试给业界提了个醒:别被 demo 的流畅输出骗了,感知能力的差距评估应该回到标准化任务上。
原文:https://the-decoder.com/new-benchmark-confirms-ai-models-still-perform-poorly-at-visual-perception/
研究打脸:自主 AI 研究没那么近
一项研究反驳 Anthropic 和 OpenAI 关于自主 AI 研究即将实现的乐观说法,认为目前技术差距仍大。两家头部 lab 今年都在对外释放强信号,将自主研究 AI 作为近在眼前的里程碑,这项研究直接泼了冷水。
关键点在于,反驳的依据不是理论层面的不可能,而是对现有模型在真实科研流程中的表现做了系统性评估。结论是:模型在文献理解、假设生成、实验设计这些环节的完成度,离“自主”还差着数量级。
为什么重要:自主 AI 研究的叙事直接关系到融资预期、算力投入节奏和人才流向。如果这条路线被证明远未成熟,那么业界对 AI 生产力的幻想就该下调一档。判断力比乐观更重要,这份研究提供了一个更接近现实的锚点。
World Labs 将机器人任务扩为千种仿真
World Labs 提出新方法,将一个真实机器人任务转化为数千个模拟变体用于训练。它的核心思路是:不再依赖海量真实数据,而是从一个 seed 任务通过仿真生成覆盖各种形态、环境、物理条件的变体。
关键点在于数据效率的提升幅度。机器人领域长期受困于真实数据采集成本高、标注难,World Labs 的做法相当于把单条真实轨迹的价值放大千倍。如果这套方法在更多任务上成立,机器人训练的数据瓶颈会大幅缓解。
为什么重要:机器人学习的 Scaling Law 一直不清晰,最大障碍就是数据供应跟不上。仿真变体的规模化生成提供了一条现实的路径,值得关注它是否能从单一任务泛化到通用操作——那才是真正的拐点。
至知研究院拆权重解释大模型,成本不到 1%
至知研究院提出大模型可解释性新路线:直接拆解权重理解模型,而不是靠激活值分析或 probe 任务。最抢眼的数字是数据成本降到传统方法的 1% 以下。
关键点在于,传统可解释性方法本质上是“观测行为再推断原因”,依赖大量输入输出样本。拆权重则是直接查看模型内部的参数结构,从机制层面理解模型在做什么——如果成立,这是一种根本性的方法切换。
为什么重要:可解释性一直是大模型落地的合规短板。监管要求解释决策,学术界给的答案却始终是相关性而非因果性。权重拆解如果被验证可以跨模型迁移,那解释成本会大幅下降,合规化进度的想象空间会被打开。
Google 让同态加密私有 AI 走向实用
Google 官方博客介绍如何用同态加密(homomorphic encryption)让 AI 在加密数据上直接计算。这意味着数据所有者可以保持数据加密状态,AI 也能完成训练和推理。
关键点在于“实际可用”。同态加密一直存在算力开销大的问题,过去的方案停留在理论和 demo 阶段。Google 这次强调的是工程层面的优化进展,让这条路径第一次有了被业务采纳的可能性。
为什么重要:医疗、金融领域对数据隐私的合规要求极高,数据不出域又是客户刚需。私有 AI 如果能真正落地,数据隔离带来的合规阻碍将大幅消除。但要注意,工程可用与生产可用之间还有距离,算力成本仍是关键变量。
原文:https://blog.google/security/how-google-is-making-private-ai-practical-with-homomorphic-encryption/
AI 工作记忆远超人类大脑?
文章称 AI 拥有远超人类大脑的工作记忆容量,但这并未让它在数学上超越人类数学家。这是一个反直觉的观察:记忆容量不是数学能力的天花板。
关键点在于,数学能力依赖的不是记住更多中间结果,而是对结构的感知、对模式的抽象和对长程依赖的选择性关注。AI 的大容量工作记忆让它能暴力追踪更多信息,却没能转化为更高阶的数学洞察。
为什么重要:这指向大模型能力评估的深层问题——我们测到的能力和我们想要的能力之间可能存在错位。工作记忆容量的提升可以被 Scaling 轻易实现,但结构理解能力的提升可能有着完全不同的路径依赖。
原文:https://davidepiffer.com/p/ai-isnt-outthinking-mathematicians
隐式推理模型几乎不用隐藏状态?
arXiv 研究测试 Coconut 和 CODI 模型,发现隐式推理模型(implicit reasoning model)很少利用中间隐藏状态,可解释性存疑。所谓隐式推理,指模型在内部进行“思考”而不显式输出推理步骤,Coconut 和 CODI 正是这一路线的代表。
关键点在于这个结果有些反直觉:如果中间隐藏状态没有被有效利用,那模型表现出的推理能力来自哪里?研究中给出的推断是,模型可能更多依赖训练中形成的模式匹配,而非真正的逐步推理。
为什么重要:隐式推理被视为绕开思维链成本、同时提升推理能力的候选路线。但如果它实际上并没有具备相应的推理结构,那模型的智能表现就更加依赖数据覆盖而非机制涌现,这对安全性和可靠性评估意义重大。
训练 AI 科学家复现科研全流程
Inherent Labs 发布研究,训练 AI 科学家复现已发表研究,探索科研自动化的边界。这不是让模型读论文写摘要,而是要求它走完一个研究的完整生命周期。
关键点在于“复现”的价值密度:能复现一项研究,意味着模型已经理解了实验设计、数据分析和结果推断的完整逻辑链。在这个训练过程中,模型的科研方法论能力被系统性地约束和检验。
为什么重要:复现是科研自动化的第一级台阶,距离自动发现新知识还很远。但这条路如果被走通,科研生产效率的结构性变化是可以预见的。目前阶段更值得关注的是:模型复现的成功率有多少,以及它能否从中习得可迁移的科研直觉。
今天最值得记住的一句话:视觉感知还没过关,自主研究的叙事又被泼了冷水——AI 的底座比我们以为的还要薄。留给你的问题是:当基础能力的真实水位被逐步揭示,那些建立在乐观预期上的产品和投资逻辑,还站得住吗?
📱 应用产品
今天值得关注的不是又一个新模型,而是 AI 产品的形态开始变了。OpenAI 将用户操作行为转化为可搜索的记忆时间线,让 ChatGPT 第一次拥有了真正意义上的“情境记忆”——AI 的记忆颗粒度正在从对话级细化到操作级。这意味着 AI 助手有能力从“随问随答”演进为“持续协作”,值得开发者与产品经理重新审视交互设计的基本假设。
记忆时间线:ChatGPT 开始记住你的每一次操作
OpenAI 发布 Computer History,将用户的点击、键盘输入等操作行为自动转化为可搜索的记忆时间线,并整合进 ChatGPT 的记忆体系。这意味着 AI 不再只记得“对话过什么”,还能记住“做过什么”。官方将其定位为情境记忆(situational memory),为 AI 执行跨会话的复杂任务提供基础。
关键点在于,操作级记忆的引入让 ChatGPT 从被动应答者变成主动协作者。用户中断任务后再次回来,AI 可以基于完整的操作历史续接上下文,而不必重新解释需求。可搜索性则是另一层能力——用户能像检索文档一样追溯自己的行为轨迹。
为什么重要:记忆是 AI 从工具走向助手的核心门槛。Computer History 把记忆的颗粒度从“聊过什么”推进到“做过什么”,为 Agentic 工作流补上了最关键的上下文拼图,也意味着用户对 AI 的信任边界将面临新的考验。
原文:OpenAI’s Computer History turns your clicks and keystrokes into a searchable ChatGPT memory timeline
水印检测 API:AI 内容治理开始长出产业链
Anthropic 发布水印检测 API,允许第三方服务检测 Claude 生成的文本水印,并进一步公开了水印的技术实现细节。这是继其 5 月宣布文本水印方案后,首次将检测能力对外开放。
关键点在于“第三方可检测”这件事本身。此前水印方案多为平台自用,而 Anthropic 选择开放检测接口,实质上是把水印从厂商的内部标记变成了行业公共基础设施。配合技术细节披露,第三方审计、内容溯源、合规监管都有了下游生态的发展空间。
为什么重要:文本水印是解决 AI 内容滥用的少数可行技术方案之一。Anthropic 开放检测能力,是在押注“可验证的 AI 内容”会成为刚需——这在深度伪造防范、版权争议、内容审核等场景中都有直接应用价值。
原文:Anthropic shares more details about how Claude’s new watermarks will work
持久化环境:AI 智能体的“身体”来了
Cloudflare 发布 Computer,为 AI 智能体提供持久化运行环境,使其能够长期保存状态并执行复杂任务。这一基础设施层产品将云平台的能力从静态资源转向动态执行环境。
关键点在于“持久化状态”。此前 AI Agent 在执行多步骤任务时,状态存储往往是碎片化的,任务一中断就难以恢复。Cloudflare Computer 将状态保存变成平台级能力,配合其全球边缘网络,Agent 可以接近实时地在不同地理位置持续运行。
为什么重要:Agent 要成为真正的生产力工具,需要一个能“住下来”的地方。Cloudflare 做的是 Agent 的操作系统底座。这类基础设施的成熟度,决定了 Agent 应用能跑多远。
Google 水印新政策:可见水印退场,隐形标记上位
据 TechCrunch 报道,Google 将允许用户关闭 AI 生成内容的可见水印,但不可见的识别标记仍会保留。这一改动适用于 Google 的 AI 生成图像等服务。
关键点在于可见与不可见水印的分离。可见水印影响用户体验,一直是 AI 生成内容传播的阻力;而不可见标记(如 metadata 或隐式编码)可以在后台记录来源,兼顾传播力与可追溯性。Google 的做法是在用户体验与内容治理之间找平衡点。
为什么重要:这表明头部平台对 AI 内容标识的共识正在从“强制可见”转向“技术溯源”。对内容平台和合规团队来说,识别能力将比肉眼可见的标记更关键——水印的博弈正从表层走向深层。
具身智能落地欧洲:从发布会走进商超
成立仅 4 个月的索塔无界宣布与欧洲最大商超集团达成战略合作,未来 3 年将部署超千台具身智能机器人。这家公司并未选择从工厂场景切入,而是直接锁定商超这一高频、场景密集的物理空间。
关键点在于订单规模与实际场景。千台级别的部署意味着具身智能从原型验证走向批量落地,商超场景的货架管理、盘点、分拣等任务复杂度适中,是机器人能力验证的合适练兵场。欧洲市场对自动化的需求与劳动力成本结构也提供了机会窗口。
为什么重要:具身智能最大的瓶颈从来不是硬件,而是场景里能不能跑通。这笔合作如果如期交付,将给整个赛道的商业化路径提供一个可参照的样本。
MOS2:重载机器人刷新行业上限
鹿明机器人发布重载轮臂式具身智能机器人 Lumos MOS2,号称全球首个双臂负载 50kg 的轮臂式机器人。这一载荷水平远超常见的桌面级机械臂,直接瞄准工业搬运场景。
关键点在于“轮臂式”与重载的结合。轮式底盘保证移动性,双臂负载 50kg 意味着可以处理真实的工业物料,而非停留在演示层面。这类产品定位填补了“人形机器人”与“固定机械臂”之间的空白地带。
为什么重要:商用机器人厂商都在找差异化定位。鹿明选择重载这一细分赛道,避开了人形机器人的激烈竞争,也回应了制造业的真实需求——先能干活,再谈形态。
千问办公首发 GLM-5.3 与 DeepSeek V4 Pro:国产模型矩阵成型
阿里旗下 Agent 产品千问办公首发上线 GLM-5.3 和 DeepSeek V4 Pro 两款前沿模型,至此累计支持三款国产旗舰模型。千问办公正从一个文档工具转向通用 Agent 入口。
关键点在于“首发”与“多模型”的组合策略。千问办公没有绑定自家通义模型,而是将 GLM、DeepSeek 等竞品模型接入同一平台,让用户按场景选择模型。这实际上是在建立模型中立的分发层,也说明国产模型的能力已经可以支撑商业产品的多模竞争。
为什么重要:多模型分发正在成为 Agent 产品的标准形态,“不做模型只做入口”的策略让应用层有更大议价空间。国产模型生态的成熟度也借此得到验证。
百度 GenFlow 更名「库库AI」:办公战场再添独立端
百度文库网盘通用智能体 GenFlow 正式官宣中文名「库库AI」,同步上线 PC 客户端、网页端、小程序及企业版,从插件工具转向独立应用。
关键点在于“更名+多端”的组合动作。中文名降低用户认知门槛,多端覆盖补齐使用场景,企业版则直指协同办公市场。百度正试图把 GenFlow 的文档处理能力沉淀为一个独立的办公产品入口。
为什么重要:大厂 AI 办公产品的竞争正在从模型能力转向产品完整度。库库AI 依托百度文档与网盘的存量场景,能否在钉钉、飞书、WPS 的夹缝中撕开一个位置,取决于这次品牌升级后的获客节奏。
今天的应用层产品,一半在给 AI“装记忆和身体”(OpenAI、Cloudflare),一半在给 AI“上户口和找活干”(Anthropic、Google、具身智能厂商)。当 AI 能记住你做过什么,并且能持续执行任务时,产品逻辑就不再是“打开应用”,而是“委托助手”——你有没有想好,哪些工作愿意交给一个会记住你所有操作习惯的 AI?
💭 行业观点
今天是 2026 年 8 月 16 日。今天最值得关注的一条新闻:HN 上 931 分的高赞文章质疑 Opus 5 的实际体验「越用越差」,并由此引爆了对模型能力评估方式的系统性反思。这并非孤立的体验问题,而是 AI 信任危机的一个切面——从法庭 prompt 注入到 AI 书籍淹没亚马逊,从 Twitch 默认抓取数据到职业专长被掏空,AI 正在从技术竞赛演变为社会契约的全面重写。
Opus 5 为何用起来更差了?
一篇 HN 高赞文章(931 分)直言 Opus 5 的实际使用体验比预期更差,迅速引发关于「模型能力到底该如何评估」的激烈讨论。文章作者认为 Opus 5 在基准测试中表现出色,但真实场景下的推理质量、指令跟随稳定性和细节一致性均令人失望。讨论中大量开发者表示「有用性」和「基准分」之间的鸿沟正在扩大,一个在榜单上领先的模型,实际编码或写作时可能频繁出现低级失误。
关键点在于:这已经不是第一次用户对新一代旗舰模型感到「变笨了」。HN 评论区集中指向两个解释——一是训练数据日益依赖合成数据,模型在真实分布上退化;二是评估基准本身已被优化到失真,厂商「刷榜」策略使得分数不再反映可用性。
为什么重要:当「第一梯队模型」的实际体验持续与预期背离,企业选型、开发者信任和定价逻辑都会受到连锁冲击。这正是 AI 行业从「能力竞赛」转向「体验竞赛」的信号。
原告在法庭文件中隐藏不可见 AI 指令
一名原告怀疑法庭使用 AI 审案,在提交的文件中嵌入了不可见的 prompt,试图在 AI 自动审查系统读取文档时注入指令来影响案件结果。法官发现后发出严厉警告,称这是对司法程序的「攻击」。
关键点:这起事件暴露了两件事——第一,AI 已经进入司法文档审查流程,当事人需要「反向推断」系统行为;第二,对抗性 prompt 注入正在从黑客攻击场景蔓延到法律战场。法官的警告明确了立场:无论系统是否存在,法庭权威不接受被操纵。
为什么重要:当政府机构、法院和监管系统开始使用 AI 处理文本输入,针对这些系统的 prompt 攻击将成为新的法律灰色地带。「隐藏指令」可能很快成为取证和抗辩的新焦点。
原文:Suspecting court of using AI, man injected prompts in filings to try to win case
女子指控继父用 Grok 将童年照变为色情图
一名女性公开指控其继父使用 xAI 的 Grok 将她的童年照片转化为露骨色情内容。这起案件引发了对 AI 图像生成工具在真实案件中滥用的高度关注,也再次将深度伪造(deepfake)的受害者保护问题推上台面。
关键点:图像生成模型对「真人照片」的加工能力已经到了只要一张童年照就能生成完整露骨内容的地步。比起陌生人用爬取照片制假,更令人不安的是「家庭成员利用身边照片作案」的场景已经出现。平台方对此类行为的监测、举报和追溯机制仍然严重不足。
为什么重要:AI 工具的滥用不只是技术问题,更是法律与产品设计的失职。每一次这类事件都在压缩公众对生成式 AI 的容忍度,也会推动更严格的内容监管落地。
原文:Woman claims her stepfather used Grok to transform childhood photo into explicit imagery
亚马逊可用 Twitch 内容训练 AI,需主动退选
Twitch 已默认允许亚马逊使用主播的直播内容来训练 AI,主播若不想被采集,需要手动进入设置界面关闭相关选项(Opt-out)。这一政策在主播群体中引发强烈反弹。
关键点:默认同意、手动退选的设计,是把「不同意」的成本转移给了个人创作者。对于大量小型主播来说,他们往往根本不会注意到设置中又多了一个需要关闭的开关。更重要的是,Twitch 主播的语音、互动方式、内容风格都是高度个人化的,一旦被纳入训练数据,难以撤回。
为什么重要:训练数据的获取正在从「公开抓取」转向「平台默认占用」。当默认行为是「你的内容归我训练模型」,用户授权的形式意义大于实质意义,这将成为未来 AI 数据和版权谈判的一个关键战役。
原文:Amazon uses your Twitch content to train its AI. How to opt out
AI 生成书籍泛滥亚马逊,人类作者销量受损
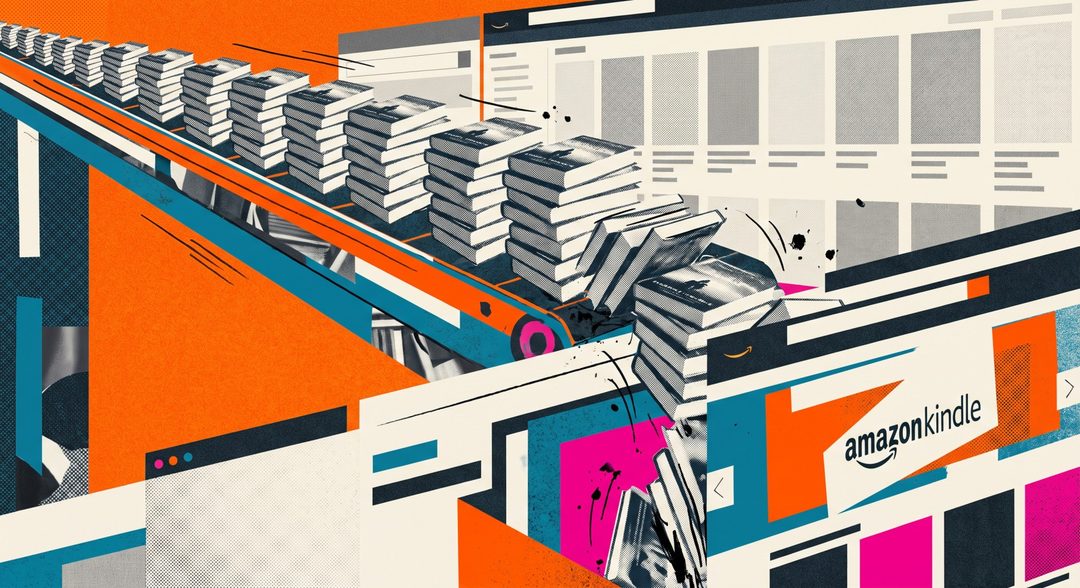
AI 生成的书籍正以极低成本和极快速度涌入亚马逊,直接挤压人类作者的销量和收入。大量同质化、低质量内容充斥搜索结果,消费者越来越难以分辨「真人创作」和「机器生成」。
关键点:这不是个别现象,而是平台内容生态的结构性失衡。AI 书籍的成本接近于零,可无限量产出,传统作者的创作周期和成本完全没有竞争力。亚马逊的推荐算法没有为「人类作者」设置差异化保护,导致优质但冷门的书更难被发现。
为什么重要:当平台无法区分内容来源的质量信号,创作者经济就失去了基础。如果连亚马逊这样的头部平台都无力拦截 AI 内容的洪流,整个出版业的价值链都会被重写。
原文:AI-generated books are flooding Amazon and tanking sales for human authors
Codex 与 Claude Code 负责人公开互怼
OpenAI Codex 和 Anthropic Claude Code 的负责人公开在社交媒体上「对喷」,各自声称自家 AI 编程工具才是最强的。这场口水战迅速演变为两大 AI 编程工具阵营的支持者大战。
关键点:这显然不是单纯的技术争论,而是两家公司抢占 AI 编程工具市场的营销动作。Codex 与 Claude Code 代表了两种产品路线:一个强调自动化完成任务,另一个强调人机协作和代码审查。在真实工程场景中,两者的差异远没有宣传中那么「非此即彼」。
为什么重要:AI 编程工具是当前 AI 商业化落地最扎实的方向之一,负责人公开互怼说明这个赛道的竞争已经进入白热化阶段。但技术选型不应被舆论战左右,真正值得关注的是两者在长尾场景中的实际表现。
Tim O’Reilly:大 AI 实验室不懂用户要什么
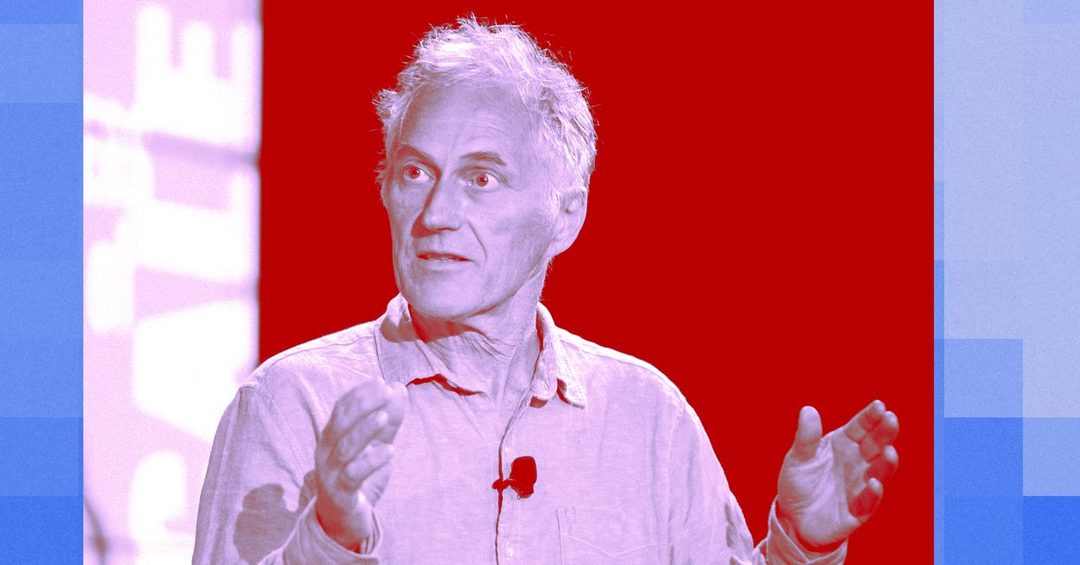
出版业传奇人物 Tim O’Reilly 在采访中表示,大型 AI 实验室「并未真正理解人们需要什么」,而他真正热爱的方向是开源 AI。O’Reilly 认为,闭源大模型追求的是「通用能力」,但用户真正需要的是能够解决具体问题、可定制、可验证的工具。
关键点:O’Reilly 不是反对 AI,而是反对 AI 开发的「供给方思维」——实验室决定做什么,用户只能被动接受。开源 AI 允许社区按需修改和适配,价值在于它是「需求驱动的」。这一判断和今天 AI 圈的主流叙事形成了鲜明对照。
为什么重要:当 AI 行业被少数几家巨头主导,产品方向容易偏离真实用户需求。O’Reilly 的发言为「开源路线」提供了重量级背书,也为那些想在巨头阴影下突围的小团队提供了一种值得关注的方向。
原文:Tech visionary says the big AI labs don’t get what people want
「认知公地悲剧」:AI 正在摧毁职业专长
一篇观点文章认为,理性采用 AI 的个体行为将导致整个职业的专业知识体系被掏空,形成「认知公地悲剧」。每个从业者都有充分的个人理由使用 AI 替代基础训练和思考,但当所有人都这样做时,职业共同体将失去传承和创新所依赖的土壤。
关键点:知识获取的便利性正在改变「专长」的形成机制。医生、律师、程序员等职业的核心能力——判断力、经验直觉、行业隐性知识——都需要大量主动练习来建立。AI 工具让从业者跳过了「刻意练习」的过程,短期效率提升,长期却是整个行业的认知萎缩。
为什么重要:这解释了为什么我们看到越来越多「看起来合理但经不起推敲」的专业产出。当 AI 替代了思考的入口,人类就只负责验收 AI 的结果,专业的可信度和权威性正在因「集体理性」而瓦解。
今天这 8 条新闻有一个共同底色:AI 的信任赤字正在从技术圈扩散到法律、内容创作、职业体系和社会契约。当每个工具都在变得更强大,值得想想——还有什么,是我们需要亲自掌握的事。
⚙️ 开源工具
今天开源圈最值得看的一件事,是 DeepSeek 正式开源了 Harness 框架,把模型、工具和 Agent Loop 全部做成插件。这标志着 Agent 基础设施的竞争从「模型能力」转向「框架生态」——当模型本身趋于同质化,谁能定义 Agent 的执行环境,谁就掌握了下一代开发者的入口。
DeepSeek 开源 Harness:模型工具全是插件
DeepSeek 正式开源 Harness 框架,这是一套 Agent 执行环境的完整实现,核心设计是「一切皆插件」:模型、工具、Agent Loop 均以插件形式接入,框架本身不绑定任何特定模型或工具链。社区已基于该框架开发出长期记忆模块、电子宠物等玩法,官方同时发布了 awesome-deepseek-agent 资源列表,汇总了生态内的插件和示例。
关键点在于 Harness 把 Agent 运行时的三个核心组件全部抽象成可替换的插件接口,本质上是在建立一个「Agent 的 App Store」。模型插件意味着用户可以在同一框架内切换不同大模型,工具插件让 Agent 的行动能力可以按需组装,Loop 插件则允许开发者替换 agentic 推理循环的逻辑。
为什么重要:此前 Agent 框架的竞争焦点是「如何写好一个 Agent」,DeepSeek Harness 把竞争推到了「如何定义 Agent 的生态标准」层面。开源 + 插件化的组合,使其有机会成为 Agent 开发的事实基础设施。虽然生态尚在早期,但这是 Agent 领域值得关注的架构级信号。
Lightricks 开源 LTX-2 音视频生成模型
Lightricks 发布 LTX-2 的官方 Python 推理和 LoRA 训练包,正式开源音频-视频生成模型。这意味着开发者可以在本地部署并微调该模型,而不必依赖厂商的 API 服务。
关键点是 LTX-2 将音频与视频的生成统一在一个模型框架内,LoRA 训练包的开放降低了定制化成本。此前开源视频生成模型多为单向文本到视频,音视频联合建模且附带训练工具链的开源发布,在这个赛道上并不常见。
为什么重要:视频生成模型的本地部署与微调门槛正在快速下降。LTX-2 的开源发布,让做短视频工具、游戏素材、营销内容生成的小团队有了底模选择,也意味着这一领域的竞争正式从「谁能生成」进入「谁能生成更可控」的阶段。
Flue 2:给 Agent 引入 React 式 Hooks
Astro 作者打造的 Agent 框架 Flue 2 发布,核心创意是把 React Hooks 的理念引入 Agent harness。开发者可以用 useState、useEffect 这类心智模型来管理 Agent 的状态、生命周期和副作用。
关键点在于它不是在一个新名字里重复「写 prompt + 调工具」的老套路,而是尝试用「声明式 + 响应式」的方式描述 Agent 的行为。Hooks 解决了 React 组件开发中的状态管理难题,Flue 2 想把这个答案迁移到 Agent 开发中。
为什么重要:Agent 开发的体验长期停留在「调用框架 API」的层级,缺乏组件化和复用规范。Flue 2 的思路如果跑通,Agent 开发者可能获得类似 React 生态的组件复用和状态管理能力。由 Astro 作者主导,意味着这个框架在工程实践上有一定说服力。
RAGFlow:开源 RAG 引擎登顶趋势榜
RAGFlow 作为领先的开源 RAG 引擎,融合 Agent 能力为 LLM 提供上下文层,近期登上 GitHub 趋势榜。它不是一个简单的文档检索工具,而是把检索增强生成(RAG)做成了 Agent 的知识底座。
关键点是 RAGFlow 强调了「上下文层」这个概念——LLM 需要的不是更多文档,而是经过整理、与当前任务相关的上下文。它把知识库管理、检索、重排序与 Agent 的决策过程做了集成,让 RAG 不再只是「查资料」,而是 Agent 行为的一部分。
为什么重要:RAG 与 Agent 的结合正在成为开源社区的关注重点。RAGFlow 登顶趋势榜说明,开发者在为 Agent 构建可靠的知识来源时,仍缺少好用的基础设施。RAG 作为 AGI 时代最务实的落地技术之一,其开源生态的活跃度是值得长期观察的指标。
Unsloth 本地 UI 支持 Qwen3.8 等新模型
Unsloth 的本地 UI 现可运行和训练 Qwen3.8、Kimi K3、DeepSeek-V4 等最新模型。Unsloth 以高效微调出名,其本地 UI 提供了图形化的模型加载、推理和训练入口。
关键点是 Unsloth 保持了「新模型发布即支持」的节奏,成为观察模型开发生态的一个窗口。Qwen3.8、Kimi K3、DeepSeek-V4 这几个名字出现在同一份支持列表里,说明开源模型生态已进入多强并立的密集发布期。
为什么重要:本地微调工具链对主流新模型的同步覆盖,是开源模型能否真正被采用的前提。Unsloth 的更新频率与覆盖面,直接降低了开发者在本地实验新模型的摩擦成本。它不只是工具更新,也在折射整个开源模型格局的演变速度。
Needle 2:14MB 微型模型跑在手机和机器人上
Needle 2 是一个仅 14MB 的基础模型,面向手机、可穿戴设备、智能家居和机器人等小型设备。模型体积仅为传统大模型的千分之一量级,却能提供基础的自然语言推理能力。
关键点在于「基础模型」的定位——它不是大模型的蒸馏版本,而是为边缘设备原生设计的小型模型。14MB 的参数量意味着它可以直接驻留在设备端运行,无需联网、无需云端算力,天然具备低延迟和隐私保护优势。
为什么重要:当所有人的注意力都在大模型竞赛上时,Needle 2 代表了一条反向路线——把模型做小到可以嵌入任何设备。手机、家电、机器人如果都内置一个小型语言模型,AI 的覆盖场景将从「打开 App」扩展到「环境即接口」。开源意味着这条路线可以被更多硬件厂商直接采用。
开源技能库让 AI Agent 变身科学家
scientific-agent-skills 提供 161 个经过验证的科学技能和 100+ 科学数据库,被全球 17 万科学家使用。项目定位是给 AI Agent 提供做科学研究的「操作手册」。
关键点是「经过验证」——这些技能不是简单的工作流模板,而是经过真实科研场景验证的操作流程。161 个技能覆盖实验设计、文献分析、数据解读等环节,配套的 100+ 科学数据库让 Agent 在回答问题时可以调用专业数据源。
为什么重要:AI for Science 的口号喊了很多年,但通用 Agent 面对专业科学问题时往往「不知道该怎么操作」。科学技能库把隐性知识显性化,让 Agent 可以按照正规科研方法行动,而不是凭模型记忆自由发挥。17 万科学家的使用量,是这个方向可行性的一个实证。
holaOS:开源一体化 AI Agent 工作区
holaOS 是开源 AI Agent 工作区,可在 100+ 工具集成和共享内存中运行 Claude Code、Codex 等任意 Agent。简单说,它是一个让多个 Agent 在一个统一环境内协作的操作系统层。
关键点是「共享内存」和「任意 Agent」两个设计。共享内存解决了多 Agent 协作时的信息传递问题,不同 Agent 可以共享上下文而不必反复传递 prompt;「任意 Agent」则意味着它不绑定特定厂商,Claude Code、Codex 等都可以在同一环境内共存运行。
为什么重要:Agent 使用者当前最大的摩擦之一,是不同 Agent 工具各自为政,上下文割裂、工具链重复配置。holaOS 想做的事情,是像操作系统统一管理进程和内存一样,统一管理多个 Agent 的生命周期与资源共享。这个方向如果得到社区认可,Agent 工作方式可能从「单工具使用」走向「多 Agent 协同」。
模型层竞争依旧激烈,但 harness 层正成为开源世界的新焦点——当 Agent 的「操作系统」开始标准化,应用层的创新空间或许会比我们想象的更大。