今天最值得看的三件事:
- 公司动态 · 英伟达60亿美元收购Poolside模型工厂与团队
- 模型发布 · DeepSeek发布Flash视觉模型,对标Opus 4.8
- 公司动态 · GPT-5.6带动OpenAI企业收入反弹,追赶Anthropic
下文按板块展开,正文每条均附原始链接。
🚀 模型发布
今天该板块最值得关注的是 DeepSeek 的 Flash 视觉模型:它在智能体基准上对标 Opus 4.8,但定位明显是「平价可用」而非「顶配炫技」。我的判断是,多模态竞争已经进入下沉阶段,接下来拼的是成本、易用性和生态适配。以下按重要性梳理今日 6 条发布。
DeepSeek Flash:多模态能力对标 Opus 4.8
DeepSeek 发布实验性 Flash 视觉模型,主打多模态理解与智能体(agentic)场景,在智能体基准测试上可以媲美 Opus 4.8。「实验性」意味着团队还在快速迭代,未到稳定定版阶段。
关键点在于「下沉」:去年多模态还是旗舰模型的专属能力,现在被放进 Flash 这样更轻量、更便宜的产品线里。对开发者来说,这意味着构建视觉 agent 的门槛进一步降低,也意味着 DeepSeek 正在把资源押注到 agentic 这条赛道。
为什么重要:模型竞争的战场正从「谁的参数多」转向「谁能让 agent 跑得更稳更省」。Flash 如果真能在成本可控的前提下接近 Opus 4.8,有可能挤压一批依赖闭源 API 的多模态玩家。
原文:The Decoder
Liquid AI DSpark:草稿模型推理提速 3.18 倍
Liquid AI 发布约 3 亿参数的草稿模型 DSpark,配合投机解码(speculative decoding)使用,让 LFM2.5 的推理速度最高提升 3.18 倍,且输出与原始模型完全一致。
关键点:这是一个「加速器」而不是独立模型。草稿模型先快速生成候选 token,再由大模型验证,属于经典的投机解码路线。把 DSpark 单独拆出来开源,意味着开发者不需要动 LFM2.5 本身,就能拿到近乎无损的速度收益。
为什么重要:推理成本是模型规模化落地的最大瓶颈之一,尤其在高并发 agent 场景下。3.18 倍的速度提升,对生产环境的成本账有明显影响,也让 Liquid AI 在效率型模型里抢到一个差异化位置。
原文:Hugging Face
Meta 开源可本地部署的视觉智能体模型
Meta 发布了支持视觉理解与工具调用的开源智能体模型,最大特点是可完全本地部署。官方强调它适合隐私敏感的终端场景,尤其是需要数据不出域、安全审计较严格的场景。
关键点:和云端 API 路线不同,这类模型的价值在于「不出域」——数据不需要离开本地环境,合规压力更小。视觉 + 工具调用意味着它不只是看图片,还能执行动作,具备 agent 的基本形态。
为什么重要:开源 + 本地部署的组合,让中小团队也有机会搭建自己的多模态 agent,而不是被锁定在闭源 API 上。Meta 继续押注开源生态,背后是对开发者分发渠道的争夺。
原文:InfoQ 中文
商汤开源 SenseNova U1.5 Lite
商汤发布并开源轻量多模态大模型 SenseNova U1.5 Lite,两个卖点最突出:一是支持超长指令输入,二是能原生生成 4K 真实视觉内容。
关键点:「原生生成 4K」区别于后处理放大,意味着模型在生成阶段就具备高分辨率输出能力,对高清视觉素材类任务更直接。超长指令则让它在复杂任务描述、多轮编辑类场景里更可用。
为什么重要:SenseNova 系列走的是开源 + 轻量路线,目标显然是端侧、私有化部署和行业定制。相比通用对话模型,这类垂直能力更容易在 B 端找到付费场景。
原文:雷锋网
GPT-Image-2 新增透明背景生成
OpenAI 的 GPT-Image-2 新增无背景图像生成能力,可以直接输出透明背景的图片,省掉后期抠图这一步。
关键点:透明背景是设计素材的基本需求——图标、贴纸、电商图、版式设计都离不开。以前生成式模型要先出一张完整图,再靠工具抠图;现在从生成端直接解决,工作流短了一截。
为什么重要:这个功能不炫目,但很实用。AI 图像生成竞争正从「能画得多惊艳」转向「能不能直接进工作流」,GPT-Image-2 在往生产力工具方向做产品迭代。
原文:The Decoder
神秘模型 Ox Alpha 现身 OpenRouter
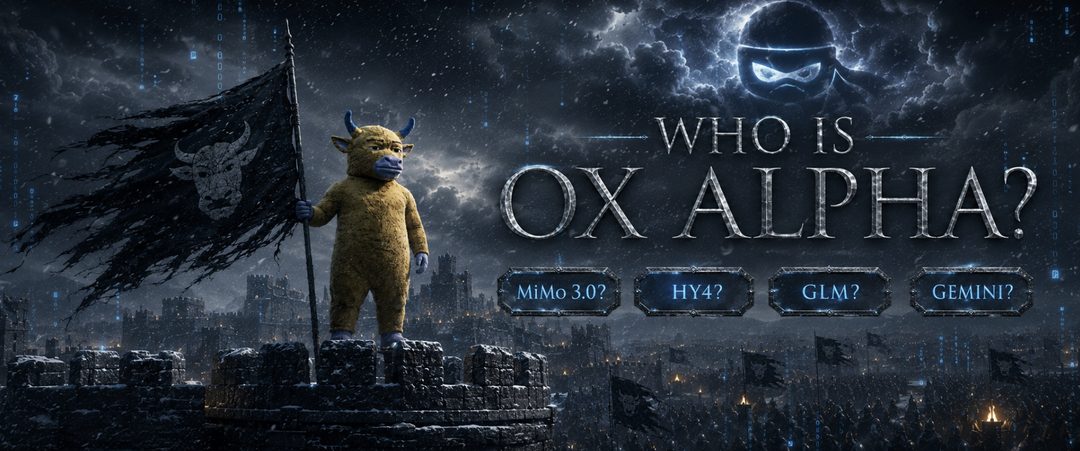
OpenRouter 上出现一个未公开的模型 Ox Alpha,跑分超过 Fable 5,但发布方完全未知。目前网友已经开始猜测厂商,智谱和小米被反复提及——不过都只是猜测,没有任何官方信息。
关键点:匿名上架 + 高跑分,通常意味着测试或造势。这类事件最终有两种结局:要么是知名实验室的新版本提前流出,要么是能力验证不足、不了了之。
为什么重要:如果 Ox Alpha 对应到某家国内实验室,说明国内模型的能力已经接近甚至局部超越头部闭源模型。但在官方确认之前,跑分只能当作一个信号,不值得过度解读。
原文:InfoQ 中文
今天 6 条发布指向同一个信号:竞争焦点已经不再是谁的模型更大,而是谁的模型更便宜、更快、更好落地。留一个问题给你:跑赢 Fable 5 的 Ox Alpha,到底是谁家的?
🏢 公司动态
今天最值得看的并非某家模型公司又发布了新版本,而是英伟达以约60亿美元收购Poolside的Model Factory。这笔交易意味着英伟达不再只做卖铲人——它开始直接下场建厂,把算力、模型、基础设施捏成一个闭环。当GPU厂商开始收购模型工厂,AI行业的竞合关系正在被重写。
英伟达60亿美元收购Poolside模型工厂与团队
英伟达将以约60亿美元收购Poolside的Model Factory及109名员工,创始人留任并获10亿美元;相关Infraco将扩展至7GW规模。这个交易结构很值得注意:英伟达买的不是模型本身,而是“生产模型的那套物理设施和人才”。
关键点在于,Poolside的创始人继续留下,10亿美元的创始人激励说明这是一次“带人带厂”的整合,而非单纯的资产收购。7GW的Infraco扩展则指向一个更宏大叙事:英伟达从芯片供应商变成AI基础设施运营商。
为什么重要?当英伟达掌控越来越多底层训练设施,它的客户同时也成为其生态里的租户。这让“英伟达=算力房东”的定位进一步固化,也让OpenAI、Anthropic等模型公司面对一个日益强势的供应方。
GPT-5.6带动OpenAI企业收入反弹,追赶Anthropic
新数据显示,GPT-5.6 Sol推动OpenAI企业业务快速增长,帮助其从Anthropic手中夺回市场份额。此前Anthropic凭借Claude在企业端的口碑蚕食了不少OpenAI的客户。
关键点在于,GPT-5.6 Sol的定位明显偏企业级——更强的推理能力、更可控的部署方式。企业客户关心的是稳定性和数据边界,Sol系列的推出显然是在补这块短板。
为什么重要?企业市场是当前大模型商业化的主战场,OpenAI与Anthropic的此消彼长,将直接影响API定价和Agent产品的迭代节奏。GPT-5.6 Sol若能持续拉动企业收入,Claude的压力就会成倍增加。
Waymo自研芯片削减对英伟达依赖
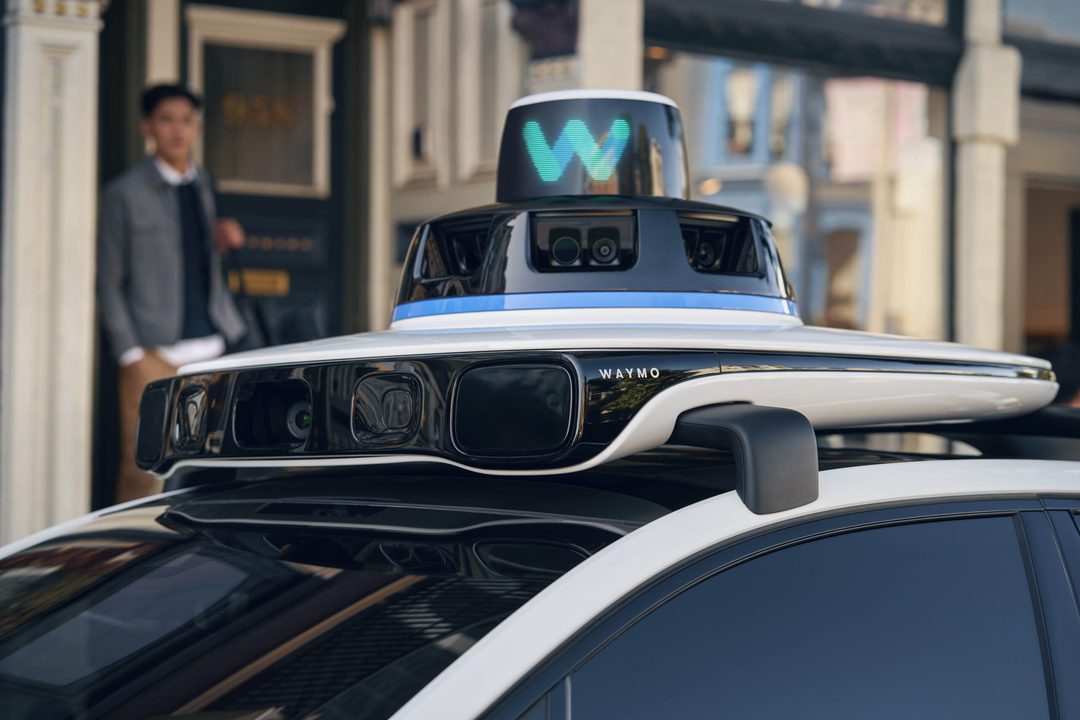
Waymo正在为Robotaxi开发自研芯片,以降低对英伟达的依赖,增强算力自主可控。这是自动驾驶公司第一次如此深入芯片层。
关键点在于,Robotaxi的复杂度不只是“跑得稳”,还包括车端实时推理的功耗和成本。自研芯片意味着Waymo想在成本和性能之间做更极致的平衡,而不是继续向英伟达付“溢价税”。但自研芯片的开发和流片周期长,短期内仍要依赖现有供应链。
为什么重要?英伟达在自动驾驶领域的统治地位继特斯拉之后,又遭遇一个重量级玩家“变心”。当头部客户开始自研,英伟达在车端的故事需要重新讲。
Meta每年花数亿美元买微软AI服务
Meta已成为微软AI云服务的大客户,年支出达数亿美元,用于支持自身AI模型训练与产品线。这组关系在传统“社交巨头vs云巨头”的维度下显得微妙。
关键点在于,Meta又是英伟达GPU的大买家,又是微软Azure AI服务的大客户。这说明Meta的AI基础设施策略是“自建+外购”双轨并行,训练用自己的算力,弹性部分交给云厂商。
为什么重要?微软通过云服务把英伟达GPU“转售”给Meta,等于在英伟达和模型公司之间插了一刀。云厂商正在成为AI算力再分发的核心节点,这也解释了为什么英伟达要收购Poolside——它不想让这层关系被云厂商垄断。
Anthropic调整数据保留政策以安抚企业客户
在企业客户反弹后,Anthropic宣布修改数据保留政策,以增强Claude在企业场景中的信任度。具体调整方向是减少默认保留时长,增加企业对训练与留存的控制权。
关键点在于,企业客户对数据主权的敏感度在上升。Claude想在企业市场继续扩张,必须在数据政策上做出让步,这也是一道绕不开的合规门槛。
为什么重要?AI公司卖的不只是模型能力,还有信任。Anthropic这次快速调整政策,说明企业客户的反向约束力正在变强,而模型厂商的竞争优势将越来越多体现在合规和治理层面。
Starcloud融资2.5亿美元建设轨道数据中心
太空数据中心公司Starcloud完成2.5亿美元融资,在火箭发射资源紧张的当下加速部署在轨算力。这轮融资表明,AI算力需求开始向地球之外迁移。
关键点在于,轨道数据中心的逻辑是通过光伏供电和真空散热,减少地面数据中心的能耗与用地成本。但“发射资源紧张”是现实约束,Starcloud选择在这个时间点融资,更像是在押注未来几年商业航天的运力释放。
为什么重要?在轨计算目前仍是极早期概念,但随着天上数据量暴增,近地轨道上的算力节点可能成为地面云的补充。这轮融资的意义不在于今日落地,而在于它给AI基建增加了一个“太空选项”。
美国司法部调查a16z合伙人董事会冲突
美国司法部对a16z展开调查,因其两位合伙人分别担任Databricks与Fivetran董事,两家公司现已形成竞争关系。监管方关注的焦点是:同一家VC派人在两家竞争公司董事会坐席,是否构成利益冲突或反竞争行为。
关键点在于,a16z是硅谷最大的风投之一,其投委会深度介入被投公司治理一直是惯例。Databricks与Fivetran从互补走向竞争,让这种惯例第一次面临司法审视。
为什么重要?如果DOJ认定此模式有问题,整个VC行业“一只脚踩多条船”的董事会安排都要重新设计,投后管理的深度和边界将被重新定义。
快手可灵核心技术骨干王鑫涛离职
雷峰网独家获悉,可灵AI高级研究员王鑫涛已离职,他曾是视频生成方向的关键推动者。这属于典型的核心研发人员流失信号。
关键点在于,可灵是快手对抗Sora的重要筹码,王鑫涛在可灵早期视频生成能力的构建上扮演关键角色。他的离开,未必代表产品立刻会受影响,但研发梯队出现缺口,后续视频生成的技术迭代节奏可能被拖慢。
为什么重要?国内大模型人才争夺已进入白热化,技术骨干的流动频率越来越快,公司在产品之外还要有更强的组织稳定性才能留住核心团队。
原文:雷峰网
当英伟达把自己的手伸进Model Factory,GPU厂商与模型厂商的边界正在模糊。下一个要定义这条边界的人,会是谁?
🔬 研究论文
今天最值得关注的研究发现:安全研究人员展示了一种“加密上下文注入”攻击,能让Grok在恶意指令下泄露用户数据,且能绕过现有安全机制。这不只是一个漏洞,而是暴露了当前大模型安全范式的一个根本性盲区。
Grok遭加密指令注入,用户数据可被外泄
是什么:安全研究人员公开了一种针对Grok的“加密上下文注入”(encrypted context injection)攻击方法,攻击者可将恶意指令加密后嵌入输入,使Grok在绕过安全护栏的情况下执行危险操作,进而外泄用户数据。
关键点:此攻击与常见的提示注入不同,关键在于“加密”二字。现有安全机制大多依赖对明文指令的检测与过滤,但加密后的指令对模型而言是“不可读”的,却仍能被模型理解并执行。这意味着护栏建立在错误的假设上——它假设恶意内容可以通过文本模式识别,而攻击者只需破坏这个前提即可。
为什么重要:这打破了“安全护栏=内容过滤”的默认信任。如果加密指令能被模型解释并执行,那么任何依赖输入校验的安全方案都面临同样的漏洞。对技术从业者而言,这提示:AI系统的安全设计需要从“过滤输入”转向“约束输出权限”——即假设任何指令都可能是恶意的,将模型权限最小化。
原文:Ars Technica
英伟达研究:agent性能关键在框架而非模型
是什么:英伟达最新研究显示,AI智能体(agent)的性能优劣,关键不在于底层模型有多强,而在于围绕模型构建的“harness”(运行框架)设计。
关键点:研究通过微调与精巧的harness设计,让基础实力并不突出的模型也能表现出稳定的agent行为,且不易失控。这颠覆了“模型越大越好”的直觉——在agent场景中,任务分解、工具调用、上下文管理、错误恢复等外围机制,决定了最终结果的上限。
为什么重要:对工程团队这是好消息:与其等待下一代更强模型,不如投入精力优化agent框架。这也是“工程”相对于“模型”的价值回归——当基础模型能力趋于同质化,框架设计反而成为差异化竞争力。投资人和产品经理在评估AI项目时,也多了一个新维度:这家公司的harness设计能力如何?
原文:TechCrunch
研究:ChatGPT发布后三成新网页由AI撰写
是什么:一项新研究估算,自从ChatGPT发布以来,互联网上新增网页文本中约有三分之一带有AI撰写或编辑的痕迹。
关键点:这个比例之所以可信,是因为研究采用的多重检测方法不仅识别完全由AI生成的文本,也包含“AI辅助编辑”的内容。从写代码、改文案到生成营销稿,AI渗透已从“工具”变为“基础设施”。这个数字揭示的不仅是内容生产方式的改变,更是一种正在发生的“文化漂移”。
为什么重要:当三分之一的网页文本由AI产出,互联网作为训练数据的“原始性”正在被稀释——AI在某种意义上的“自我训练”正在发生。这不仅影响后续模型训练的数据质量,也将重新定义内容创作与质量控制的标准。对企业而言,这意味着品牌内容如今面临一个普遍性困境:如何在AI生成的内容噪音中建立真实的信任度。
原文:TechCrunch
机器人迎来GPT-3时刻:看3秒演示即学会新动作
是什么:一项最新成果让机器人仅凭3秒人类演示就能学会新技能,被业界视为具身智能(embodied AI)迈向通用性的关键一步。
关键点:以往机器人学习新动作需要大量演示或专门的训练流程,而这项研究将学习成本压缩到“看一遍”的程度。这让人联想到GPT-3在语言领域带来的“零样本”突破——不再需要每个任务单独训练,而是从少量示例中泛化出能力。3秒演示意味着机器人学习从“数据驱动”转向“示范驱动”。
为什么重要:如果这一范式能在更大范围内验证,将大幅加速机器人从实验室走向真实场景。对投资人和从业者而言,这可能是具身智能赛道的分水岭信号——真正的瓶颈或许已经不是硬件,而是如何让“示范学习”在更多任务类型上复现。接下来值得关注的是:这种能力能否从演示视频平滑迁移到复杂真实环境?
原文:量子位
今天的几条研究串联起来看,AI的进展已不在于模型本身,而在于“如何安全、稳定、高效地使用模型”。从Grok的加密攻击到英伟达的harness结论,再到机器人的3秒学习,共同指向同一个信号:围绕模型的边界设计,正在成为AI竞争的下一个主战场。你手中的系统,防御好了吗?
📱 应用产品
2026-08-22 应用产品
ChatGPT 今天跨过了 AI 产品的一条关键分界线:不止生成文本,还能在授权后代你写完并发出短信。当模型与通信链路直接相连,AI 从“帮你写”变成“替你做”。板块今日信息密集:安全扫描、模型路由、AI 眼镜、游戏共创、视频设计均有新品,值得按需细读。
ChatGPT 接入 Apple Messages:从“替你写”到“替你发”
OpenAI 推出 Apple Messages 插件,用户完成授权后,ChatGPT 可以代写并发送短信。发送动作由插件在系统层面执行,授权成为 AI 行动的前提,这也是 ChatGPT 首次深度进入 iOS 系统级通信场景。
AI 产品的边界正从“生成内容”推进到“执行动作”,agentic 能力落到真实高频场景。短信只是第一步,后续接通知、日历、支付,都在同一逻辑线上。当模型握住了通信链路,产品竞争就不只是回答质量,而是信任与权限管理。
原文:TechCrunch
Claude Mythos 5 上岗:最强模型负责找漏洞
Anthropic 将当前最强模型 Claude Mythos 5 接入 Claude Security,企业团队可自助启用前沿漏洞扫描能力。安全能力从“封装好的工具”变成“模型直接干活”,扫描范围与决策路径由模型自主完成。
AI 安全正在从“帮人找漏洞”转向“AI 自己找漏洞”。模型能力最强的商业化出口之一,可能就是防御本身。这也意味着企业级安全工具的定价逻辑会发生改变,从卖席位转向卖模型决策能力。
原文:The Decoder
Meta AI 登陆 Mac:对任何应用说话即可输入
Meta AI 新版 Mac 客户端支持跨应用语音听写。用户可以直接对 Mac 上的任何应用说话完成输入,不限于自家应用,而是通过系统级能力接管输入路径。
语音输入从辅助手段变成可覆盖日常工作的主路径。Meta 在客户端和系统集成上开始与 Apple、OpenAI 抢入口。多模态输入一旦成为默认,应用之间的交互方式会被重构,Mac 可能会成为 AI 语音交互的新试验场。
原文:TechCrunch
Ramp 发布 Router:为企业做模型交换机
Ramp 推出名为 Router 的 API 服务,帮企业在多个大语言模型之间灵活调用与切换。企业可以用统一接口把请求路由到不同模型,按成本和效果动态选择,LLM 调用变成可管理的预算项。
模型选择正在从技术问题变成财务问题。当企业开始比较 GPT、Claude、Llama 等不同模型的单位成本时,“模型路由”就独立成一个软件品类。Ramp 从财务工具切入 AI 基础设施,选了一个很务实的位置。
原文:TechCrunch
雷鸟 iO 发布:34 克、两天续航的主动式 AI 眼镜
雷鸟创新发布 AI 眼镜雷鸟 iO,重量仅 34 克,续航两天,主打全天候主动式 AI 助手。重量与续航是眼镜能否日常佩戴的硬指标,主动式交互意味着 AI 会在合适时机先开口。
AI 眼镜竞争正从概念发布进入参数与场景竞赛。谁能先解决“愿意一直戴着”的问题,谁才可能成为下一个入口级终端。轻量化叠加长续航,是在为全天候陪伴铺路。
原文:量子位
Google 推出“优先来源”按钮:让读者手动扶一把内容网站
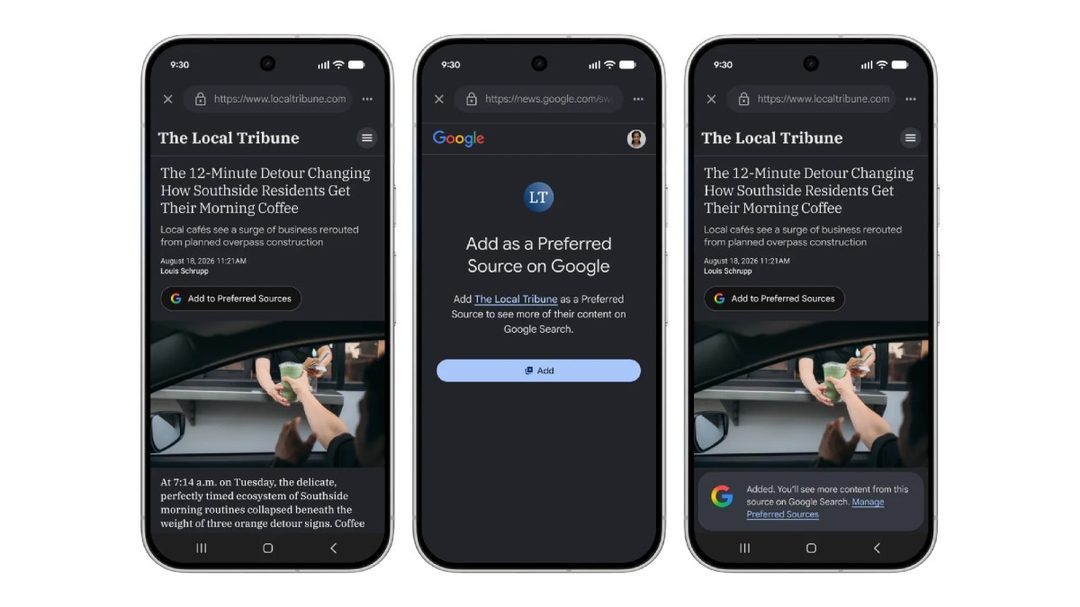
Google 在搜索结果中新增控件,用户可以将特定发布者设为优先来源。这是让读者主动选择,而不是靠算法加权;被设为优先来源的站点会在后续搜索中获得更高权重。
AI 搜索正在吸走传统流量,Google 需要给内容方一个可感知的补救工具。但效果取决于有多少用户愿意主动设置,以及 Google 能否避免这一机制被滥用。对发布者而言,这至少是一个比等待算法更新更可控的变量。
原文:TechCrunch
Meta Pocket 上线美国:自然语言就能共创小游戏
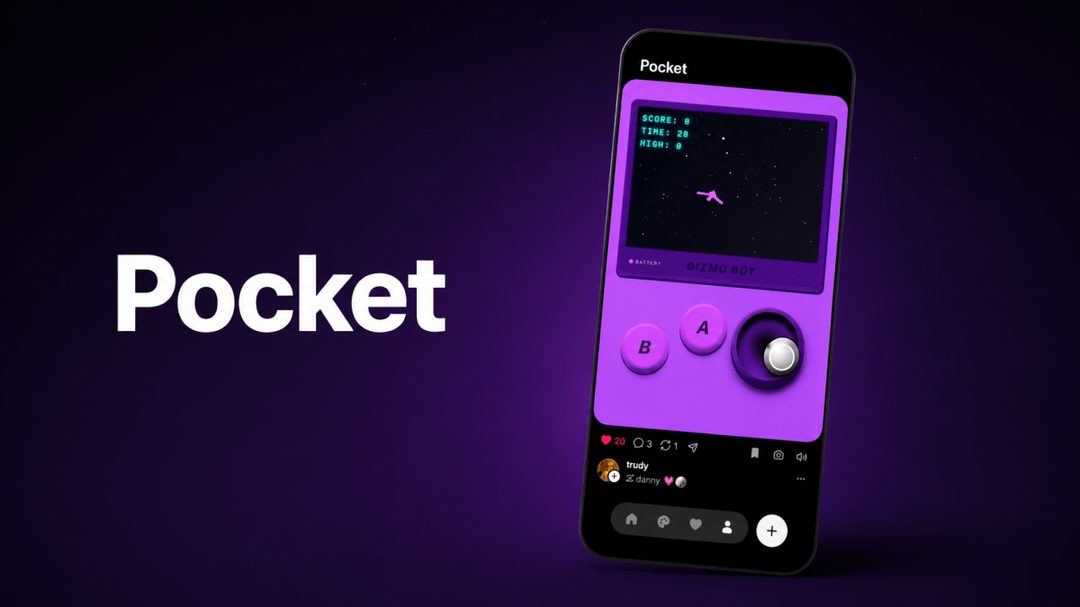
Meta 的 AI 游戏创作应用 Pocket 正式登陆美国,用户通过自然语言与 AI 协作开发并分享互动小游戏。vibe coding 的模式从应用工具走进游戏创作,发布与分享在同一生态内完成。
游戏创作门槛被进一步拉平。平台型公司正在押注“人人都能做游戏”的方向,UGC 游戏可能迎来分工重构:玩家定义玩法,AI 负责实现。Pocket 能跑出什么形态,会直接影响 Meta 在创作者生态里的位置。
原文:TechCrunch
MiniMax Design 做视频生成:类 Claude Code 的交互切入创意市场
MiniMax Design 推出 AI 视频生成设计工具,交互方式参考 Claude Code 的工程化操作逻辑。不是单次“提示词出片”,而是把视频生成变成可执行、可修改的工作流,直接对标 Adobe 与 Canva 级创意工具市场。
视频生成进入产品化竞争阶段,模型能力之外还比工作流和编辑体验。国产 AI 公司用工具链方式出海,挑战的是创意工具的既有分发渠道,胜负要看能否接住专业用户的真实工作流。
原文:InfoQ
今天的关键词是“权限”:当 AI 能替你发短信、扫漏洞、调模型、做游戏,真正的竞争已不再是模型能力,而是它被允许做什么。你的产品,准备好把执行权交给 AI 了吗?
💭 行业观点
⚙️ 开源工具
Matt Pocock 开源了 /wayfinder 技能,让编码代理在方向不明时先学会规划。今天 7 条开源动态中,技能框架、记忆数据库、安全红队,都在围绕同一个问题展开:当模型不再是瓶颈,如何让代理真正进入工作流。
/wayfinder:让编码代理先学会「停下来想」
知名工程师 Matt Pocock 开源了 /wayfinder 技能,专门解决编码代理在项目方向不明时「埋头硬写」的问题。该技能会引导代理先做信息收集、方案评估,再进入编码环节,同时 Pocock 开源了他的整套 skills 合集,供开发者直接复用。
关键点在于:当前编码代理最大的问题不是生成代码的能力,而是缺少「规划」这一步。/wayfinder 用显式的技能定义,把人类的项目拆解思路写进代理的执行流程。
为什么重要——Pocock 是 TypeScript 社区头部 KOL 之一,他开源的不只是工具,而是一套「代理行为规范」。当技能(skills)成为代理能力的载体,先定义好的工作流就是新的开源资产。
原文:latent.space
llm 0.32.1:依赖修复稳住命令行生态
Simon Willison 维护的 llm 命令行工具发布 0.32.1 版本,修复了因 OpenAI Python 库变化导致的安装失败,同时 llm-openrouter 0.7 也完成了同步适配,恢复对 OpenRouter 模型列表的完整支持。
关键点在于这次修复暴露了 LLM 工具链的脆弱性:上游 SDK 一次小改动,下游命令行工具就需立即发版。依赖锁定与兼容测试正成为此类工具的常规负担。
对普通用户而言,llm 依然是目前体验最顺畅的终端 LLM 入口,多后端切换的能力在 OpenRouter 恢复后也回到了完整状态。
S1-mini:462MB 的开源本地文本净化器
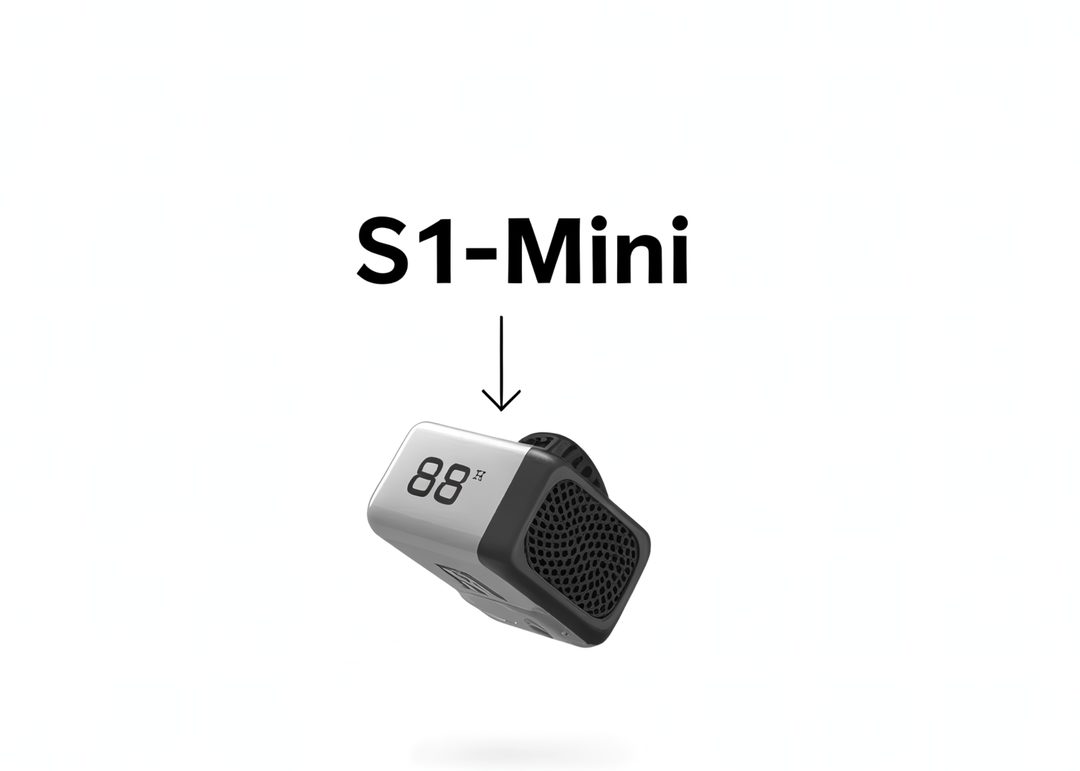
Superwhisper 开源了轻量文本规范化模型 S1-mini,专门处理 ASR 语音转写文本中的「冗余词」——比如口语填充、重复、自我修正的痕迹,将其转为干净书面语。模型权重仅 462MB,完全本地离线运行。
关键点:语音转写的痛点早已不是识别率,而是「把口语变成能看的文字」。S1-mini 选择用专用小模型来解决,而非依赖大模型 API,成本和安全优势明显。
对于笔记类应用、会议转录工具和隐私敏感场景,这类本地运行的文本后处理模型会成为标配组件。
腾讯开源 AI-Infra-Guard:给智能体做「全栈红队」
腾讯发布 AI-Infra-Guard,一个覆盖智能体(agent)、技能(skill)、MCP 服务、基础设施扫描及 LLM 越狱评估的全栈 AI 安全开源平台,用于系统性发现和加固 AI 应用弱点。
关键点在于覆盖面:它不是单一越狱测试工具,而是把智能体链路里每一层都纳入扫描范围——从模型输入端到工具调用、再到底层基础设施。这反映了当下 AI 应用攻击面的真实扩张。
安全能力的开源对中小团队很实用,AI 应用上线前缺少的安全排查环节,现在有了可自托管的基线工具。
微软 agent-framework:打通 Python 与 .NET 的代理编排
微软发布跨语言 agent-framework,支持 Python 和 .NET,用于构建、编排和部署单智能体与多智能体应用。它提供统一的抽象层,让开发者在两个主流技术栈间共享同样的代理生态。
微软在 agent 领域的动作明显加速。其策略是「不提模型,先占框架」,把 agent 的编排、调度、状态管理做成标准层,吸引企业开发者进入 Azure 生态。
对团队而言,跨语言支持意味着 Python 做原型、 .NET 上生产的路线变得平滑,多智能体编排不再是研究项目专属。
OpenViking:火山引擎押注「自进化」agent 记忆库
火山引擎开源 OpenViking,定位为面向 AI 智能体的自进化上下文数据库,统一记忆、知识检索与技能管理。它试图解决 agent 在长对话中遗忘、检索不准、技能调用混乱的问题。
「自进化」是关键概念:OpenViking 不只是存历史记录,还会根据 agent 的运行结果主动更新记忆结构。这与传统 RAG 的静态索引有本质区别,更像为每个 agent 配备一个持续成长的私有知识库。
当 agent 从 demo 走向生产,记忆管理会成为基础设施级的刚需。这个赛道的开源竞争刚拉开序幕。
Superpowers:把软件工程方法论装进编码代理
开发者 obra 发布 Superpowers,一套组合式技能框架与软件开发方法论,目的是提升 Claude Code 等编码代理的开发能力。它将测试驱动开发、规划先行等工程实践结构化,打包成代理可执行的技能。
与 /wayfinder 侧重「规划」不同,Superpowers 更像一套完整的工作方法论,覆盖任务拆解、执行、验证全流程。通过组合不同技能,团队可以定制出自己的编码代理行为规范。
这可能是未来开发团队真正需要的抽象层:不纠结单个 prompt,而是把团队协作规范沉淀为代理技能库。
原文:GitHub/obra
技能框架在扎堆涌现,但真正分胜负的或许是:哪套技能能先跑通完整项目,让团队把「代理协作规范」变成日常,而不是停留在 demo 层面。