今天最值得看的三件事:
- 应用产品 · Anthropic 将 Claude Mythos 5 用于网络安全扫描
- 模型发布 · DeepSeek 发布实验性 Flash 视觉模型,对标 Opus 4.8
- 公司动态 · DeepMind 联手游戏工作室,推进 AI 原生玩法
下文按板块展开,正文每条均附原始链接。
🚀 模型发布
今日模型发布板块最值得看的一件事:DeepSeek 推出实验性 Flash 视觉模型,据称在 agent 基准上直接对标 Opus 4.8。同一天,Meta 开源可本地运行的 agent 模型,商汤也放出了 SenseNova U1.5 Lite。一个清晰的信号是:多模态与本地化部署正成为所有主流厂商的公开战场,而开源对抗闭源的竞争,已经从对话模型烧到了 agent 与视觉领域。
DeepSeek 发 Flash 视觉模型,对标 Opus 4.8
是什么:DeepSeek 发布实验性 Flash 视觉模型,补齐多模态能力,也是其在 agent 方向布局的关键一步。
关键点:据称在 agent 基准上可对标 Opus 4.8。「实验性」定位意味着快速迭代、抢先占领生态,而非追求稳定发布节奏。
为什么重要:DeepSeek 此前以文本模型见长,视觉能力补上后,其开源权重模型在 agent 工作流中的适用面会显著扩大。若性能真能对标闭源旗舰,将进一步压缩商业模型的性能溢价空间。
原文:The Decoder
Meta 开源本地 agent 模型,支持视觉与工具调用
是什么:Meta 发布了一款可本地运行的开源 agent 模型,原生支持视觉输入和工具调用。
关键点:「本地运行」意味着数据不出设备,推理成本和隐私风险都更低;「工具调用」则让模型不再停留于对话,而是可以直接驱动实际业务流程。
为什么重要:agent 类应用此前受限于云端 API 的成本与延迟。Meta 将视觉、工具调用和本地部署打包成开源模型,直接拉低了中小团队构建 agent 产品的门槛,延续了其以开源生态换取行业影响力的路径。
原文:InfoQ
商汤开源 SenseNova U1.5 Lite,原生 4K 视觉
是什么:商汤正式开源 SenseNova U1.5 Lite,一个轻量级统一多模态大模型,支持超长指令与原生 4K 真实视觉创作流。
关键点:轻量级是部署优势,原生 4K 视觉则指向真实的图像创作场景,而非简单的图文理解。两者组合,意味着高分辨率视觉任务可以在更轻的资源条件下完成。
为什么重要:4K 视觉是复杂创作类 agent 落地的硬门槛,超长指令对应长流程任务的执行能力。商汤这次开源,等于在轻量多模态赛道上补上一个关键身位,给开发者多了一个值得评估的选项。
原文:雷锋网
神秘 Ox Alpha 突袭 OpenRouter,性能超 Fable 5
是什么:OpenRouter 上出现代号 Ox Alpha 的模型,跑分据称超过 Fable 5,但厂商背景完全不明。
关键点:没有官方说明,没有技术细节,只有一个高分和一堆猜测。匿名发布模型正在成为 OpenRouter 上一种新的注意力玩法。
为什么重要:这件事的看点不在模型本身,而在评估体系的信任问题——当模型可以换了名字上架并制造声量,benchmark 的公信力就会被稀释。与其猜「这是谁」,不如问评测机制还剩下多少参考价值。
原文:InfoQ
今日四条消息指向同一个趋势:视觉与工具调用,正成为模型发布的新基准线。问题是,开源已铺到这个程度,闭源模型的差异化还剩多少。
🏢 公司动态
今天公司动态里最值得看的不是大模型发布,而是 OpenAI 对 GPT-5.6 Sol 的 API 降价超 20%——推理成本战进入下半场,价格不再是试探,而是规模化争夺的明确信号。与此同时,DeepMind 把 15 年游戏 AI 研究推向真实玩法原型,Waymo 自研芯片,优必选在 WRC 上展出客户产线。产业链上的钱正在从「讲故事」流向「做交付」。
DeepMind 联手游戏工作室,推进 AI 原生玩法
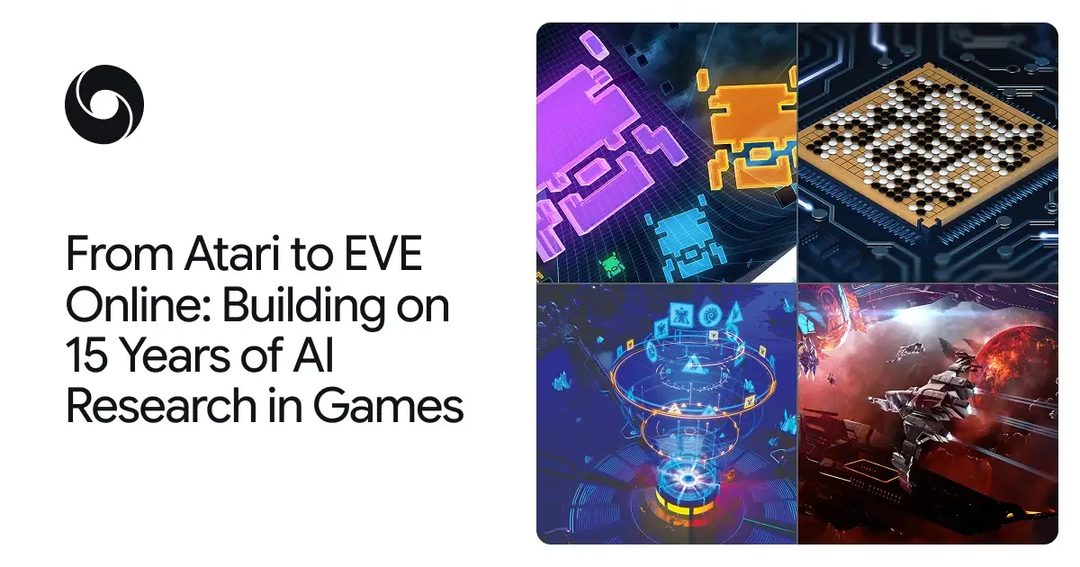
Google DeepMind 宣布与多家游戏工作室合作,将其 15 年游戏 AI 研究成果(从 Atari 到 EVE Online)落地到真实游戏玩法原型中。这不是又一篇论文,而是把 AI 放进商业游戏开发流程的尝试。
关键点在于合作对象是真实工作室、目标设定在「玩法原型」而非「Demo 演示」。DeepMind 此前在《星际争霸》和 EVE Online 中的成果多停留在研究环境,这次意在验证 AI 能否在真实游戏设计约束下产生可用的原生玩法(AI-native gameplay)。
为什么重要:游戏 AI 长期处于「研究强、落地弱」的状态。DeepMind 若能把 15 年积累的强化学习、多智能体系统转化为工作室可用的工具,将重新定义游戏行业的内容生产方式。对关注 AI 应用层的从业者,这是观察 DeepMind 商业化路径的窗口。
原文:DeepMind
OpenAI 下调 GPT-5.6 Sol API 定价超 20%
OpenAI 宣布未来 3 个月内,GPT-5.6 Sol 的 API 与积分定价下调 20% 以上,Pro、Plus、Business 订阅价格保持不变。降价仅针对开发者和 API 调用场景。
关键点:Sol 是 GPT-5.6 系列中的高性价比型号,定位于高频、大规模推理任务。此次调价不是短期促销,而是持续 3 个月的定价调整,指向明确的商业意图——在推理成本快速下降的周期里,用价格换开发者生态和市场占有率。
为什么重要:API 定价是 AI 商业化最直接的信号。OpenAI 主动降价,意味着推理成本结构已经优化到可以让利,同时也在向国内外对手施压。对下游开发者,这是调整自身成本模型、重新评估供应商的好时机。
原文:OpenAI Docs
Waymo 自研芯片,降低对英伟达依赖
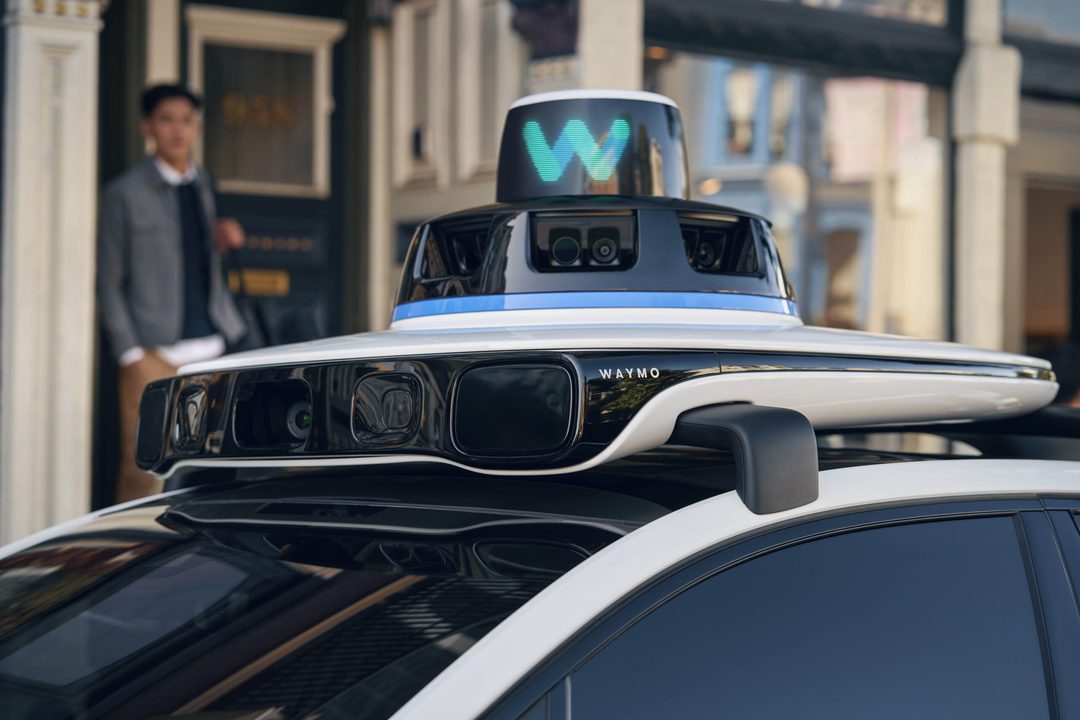
Waymo 将为 RoboTaxi 自研芯片,目标是减少对英伟达的依赖,并提升软硬协同效率。这标志着自动驾驶公司从「买算力」转向「定义算力」。
关键点:Waymo 没有公布芯片的具体制程和算力指标,但强调「软硬协同」——自研芯片可以针对自家感知、预测、规划算法做深度优化,这是通用 GPU 难以做到的。类似的路径,特斯拉已经在 FSD 芯片上走通。
为什么重要:自动驾驶的竞争已经从算法延伸到硬件体系。英伟达的 Orin、Thor 虽是主流,但头部玩家若掌握自研芯片能力,将在成本、功耗和迭代速度上获得长期优势。对供应链上下游来说,这意味着新的订单机会,也意味着英伟达在车载市场的议价权被进一步削弱。
原文:The Decoder
优必选把客户产线搬进 WRC,具身智能真落地
在世界机器人大会上,优必选 1:1 展示了客户真实产线,而非概念样机。公司强调,具身智能赛道的壁垒不在出货量,而在于落地能力。
关键点:展出的不是机器人单体,而是包含人形机器人、工业移动机器人和产线管理系统的完整解决方案。这暗示优必选的商业重心正从「卖机器人」转向「卖产线改造能力」。
为什么重要:具身智能行业过去两年估值很高,但落地案例稀缺。优必选选择把真实产线搬进展厅,是在用行动回应「只会 demo」的质疑。对于投资人,这提供了一个评估具身智能公司「真落地还是讲故事」的参照系。
原文:量子位
苹果 Siri 与 Vision Pro 团队裁员超 200 人
苹果裁减 Siri 和 Vision Pro 团队超 200 个岗位,官方称将新设岗位以推动业务和用户体验。这是苹果在 AI 和空间计算方向上的又一次组织调整。
关键点:裁员不是业务收缩,而是资源重组。Siri 在生成式 AI 浪潮中掉队明显,Vision Pro 销量不及预期。200 人的规模在苹果的版图里不算大,但信号明确——苹果正在重新排兵布阵,为下一代交互入口做人员切换。
为什么重要:苹果的 AI 战略一直「重隐私、轻声量」,但市场已经开始用脚投票。组织调整能否换来产品层面的突破,尚未可知。对行业来说,苹果的迟缓给了竞争对手更多时间窗口。
原文:36氪
东山精密加码 AI 光芯片,总投资上调至 17 亿美元
东山精密拟追加 5 亿美元投资,光芯片及光模块扩建项目总投资由 12 亿美元上调至 17 亿美元。AI 算力对高速光互联的需求,正在拉动上游产能军备竞赛。
关键点:东山精密原本是消费电子精密制造龙头,加码光芯片意味着向 AI 基础设施上游切换。17 亿美元的投资规模不小,直接对标的是光模块赛道头部厂商的扩产节奏。
为什么重要:光模块是 AI 数据中心的关键瓶颈。英伟达 GPU 出货量持续攀升,配套光模块供不应求。东山精密的加码,反映出产业链对 AI 算力需求的长期信心,也意味着光模块行业的价格战可能提前到来。
原文:36氪
科大讯飞与中国药科大学共建 AI+医药
科大讯飞与中国药科大学签署战略合作,打造「人工智能+医药」产教融合标杆。合作方向预计覆盖药物研发、临床决策支持和人才培养。
关键点:科大讯飞在医疗 AI 领域布局已久,这次选择与药科大学合作,瞄准的是「AI+制药」这个更上游的环节。产教融合模式的意义在于打通学术研究到产业落地的通道。
为什么重要:AI 制药过去两年热度回落,但底层需求仍在。科大讯飞的优势在语音和认知智能,能否延伸到药物发现的复杂场景,决定了这次合作是真布局还是占位。对行业而言,更多玩家入场有助于推动数据共享和标准建立。
原文:36氪
JetBrains 披露控制 AI 支出首批举措
JetBrains 详细说明了为控制 AI 支出快速增长而采取的首批措施。未披露具体金额,但明确提及 AI 相关计算成本正在显著影响财务。
关键点:JetBrains 的 AI 服务已嵌入 IDE(如 AI Assistant),用户量大、调用频次高,成本压力随之而来。削减措施包括优化模型调用策略、限制免费额度、引入更高效的推理方案。
为什么重要:JetBrains 的困境是 AI 应用公司的典型缩影——用户增长越快,算力成本越高,毛利越薄。它怎么平衡体验和成本,将给所有做 AI 应用的公司提供参考。控制支出不是收缩,而是 AI 商业化必须迈过的坎。
原文:InfoQ
今天的主线很清楚:AI 的钱正在从模型层流向交付层,谁能在真实场景里做出闭环,谁才握有下一轮竞争的入场券。问题留给读者——当降价成为常态,你所在的位置是受益者,还是被挤压的一方?
🔬 研究论文
今天最值得看的一项研究,解释了AI agent为何能从“skills”中受益,也指出了它们在什么条件下失效——对正在押注agent架构的团队,这是一份边界说明书。把今天五篇研究放在一起看,信号更清晰:对AI能力的评估,正在从“能不能”转向“什么时候不能”。世界模型、安全测试、推荐系统、教育应用,都在经历同一种拷问。
技能不是万能药,agent也有失效边界
一项新研究试图解释AI agent为什么能从“skills”中受益,以及它们在什么条件下会失效。研究没有停留在“技能有用”的结论上,而是把收益与失败的条件同时纳入分析框架,为agent设计提供了更细颗粒度的参考。
关键点在于:skills并非越多越好,也不是所有场景下都能稳定带来增益。理解失效条件,比堆叠技能更重要——这直接关系到agent在真实任务中的可靠性和可维护性。
对正在做agent产品的团队,这份研究的价值在于把“技能工程”从经验主义推向可分析的设计原则。
原文:Study explains why AI agents benefit from skills and when they fail
忽略人类信念,世界模型会预测错行为
新研究发现,如果world model不能模拟人类的信念,就无法正确预测人类的行为。模型可以准确建模物理环境,但一旦涉及人类行动者,缺少belief建模就会导致预测偏差。
对具身智能和人机协作场景,这是一个容易被忽视的盲区。机器人、自动驾驶、智能助理要预测人的下一步,光有环境模型不够,还得理解人“相信什么”。
这项研究把社会智能拉回了agent设计的核心位置——物理世界之外,还有一个信念世界需要建模。
原文:World models that ignore human beliefs predict the wrong actions, new research shows
心理学方法揭开AI安全测试的盲区
研究人员将心理学实验方法引入AI安全测试,发现现有安全评估存在显著盲区。传统基准测试往往只测量模型在标准数据集上的表现,而心理学方法可以暴露模型在对抗性、欺骗性情境下的真实行为偏差。
关键点在于:安全评估不能只依赖自动化基准,需要引入实验设计、对照组和诱导范式——这些心理学工具箱里的方法,恰好能补上当前评估体系的短板。
对安全团队而言,这意味着只看benchmark分数的时代正在过去,评测方法论本身需要被重新设计。
原文:Psychological methods reveal major weaknesses in AI security testing
Netflix探索用语言模型替代推荐逻辑
Netflix正在测试将语言模型与手工构建的推荐逻辑进行对比,探索用LLM替代传统推荐规则的可能性。推荐系统长期依赖人工设计的信号和排序规则,而LLM理论上可以直接从内容语义和用户行为中生成推荐依据。
关键点在于:这不是简单的“换模型”,而是推荐范式的转变——从规则驱动到语义驱动。具体评测结果尚未公开,但Netflix愿意做这样的对比测试,本身就说明传统路径的边际收益正在收窄。
对内容平台而言,这个实验值得跟踪:如果LLM能在推荐质量上逼近甚至超过手工规则,整个推荐系统的架构逻辑都会被重写。
原文:Netflix tests language model as alternative to hand-built recommendation logic
作业分涨了,考试分掉了
一项研究显示,使用AI辅助完成作业的学生,作业分数有所提高,但考场成绩反而下降。作业与考试的成绩背离,指向一个令人不安的可能性:AI可能正在替代学习过程,而非辅助学习过程。
关键点在于,作业场景的“效率提升”和知识内化的“实际效果”出现了系统性偏差。对教育科技产品来说,这是一个警示信号——如果工具只优化了产出,却没有优化能力,长期价值存疑。
AI进课堂的大方向没有变,但“帮学生完成什么”和“帮学生学会什么”之间的边界,需要被重新审视。
今天的研究有一个共同题眼:AI在某个维度上的亮眼表现,可能正以另一个维度的失效为代价。问题是——你测的那个维度,是真正重要的那个吗?
📱 应用产品
导语: 今天最值得关注的是 Anthropic 将 Claude Mythos 5 投入网络安全扫描,这标志着最强模型开始承接企业级实战任务,而非停留在对话演示层面。安全是少数能直接验证模型“判断力”的付费场景,这条产品线值得关注。
Claude Mythos 5 开启主动漏洞扫描
Anthropic 将目前最强模型 Claude Mythos 5 接入 Claude Security,企业团队可在公开测试版中启用漏洞扫描,并主动探测公共互联网资产。这意味着安全团队可以用自然语言描述攻击面,由模型自主完成资产发现与风险识别。
关键点在于“主动探测”而非被动分析,这要求模型具备持续推理和工具调用能力,属于 agentic 安全助手的早期形态。对企业而言,安全运营的人力瓶颈是真实痛点,模型如果能替代部分漏洞验证工作,付费意愿会远高于通用助手。
为什么重要:大模型在安全领域的价值不在于“更快的搜索”,而在于把专家经验压缩成可重复执行的任务流。Claude Mythos 5 的下放说明 Anthropic 开始把最先进能力直接变现,而非仅作技术展示。
原文:The Decoder
MiniMax Design 杀入视频生成,对标 Adobe/Canva
MiniMax Design 进入视频生成领域,被部分评论称为视频生成领域的“Claude Code 时刻”——意思是它可能像 Claude Code 改变编程工具链一样,改变设计工具链的形态。消息称其直接冲击 Adobe 与 Canva 的现有市场。
关键点是定位差异:这不是又一个文生视频玩具,而是以设计工作流为切入点,试图覆盖从概念到成片的完整链路。Adobe 和 Canva 的壁垒在于素材生态和协作流程,生成能力本身不难复制,难的是替换用户已经习惯的工作方式。
为什么重要:视频生成正在从“生成单条素材”走向“生成整条生产线”。MiniMax 若能打通设计与视频的边界,等于在 Adobe 的护城河上开了一个口子。
原文:InfoQ 中文
特斯拉 Cybercab 发布会定档 9 月 3 日
特斯拉宣布将于 9 月 3 日在奥斯汀举办 Cybercab 发布会。这款车由 AI 驱动,无方向盘、踏板和后视镜,属于完全自动驾驶的 robotaxi 形态。此前 Cybercab 的量产时间表多次调整,这次发布会预计会公布更明确的落地节点。
关键点不在车本身,而在监管与保险体系的配套进展。无方向盘设计意味着特斯拉必须获得监管豁免,发布会若是只谈硬件而回避运营资质问题,则量产预期仍需打折。
为什么重要:Cybercab 是特斯拉从卖车转向卖出行服务的核心载体,发布会时间是观察 AI 驾驶商业化进展的重要窗口。
原文:36Kr 快讯
人形机器人完成自主乒乓球对局
超维动力在世界机器人大会展示了全球首个人形机器人自主乒乓球完整对局,并发布 SMASH 2.0 和 KAI 世界模型。注意“自主”二字是关键:对局不依赖预设轨迹,而是基于实时感知与决策完成。
关键点在于 KAI 世界模型——它让机器人能预测球的运动并规划身体动作,这是从“程控机器人”走向“具身智能”的分水岭。乒乓球节奏快、轨迹多变,相比行走和抓取是更严苛的测试场景。
为什么重要:人形机器人行业不缺演示,缺的是可验证的闭环能力。乒乓球对局提供了客观指标,也给了外界一个观察具身智能进度的标尺。
原文:雷峰网
RayNeo 发不装摄像头的 AI 眼镜
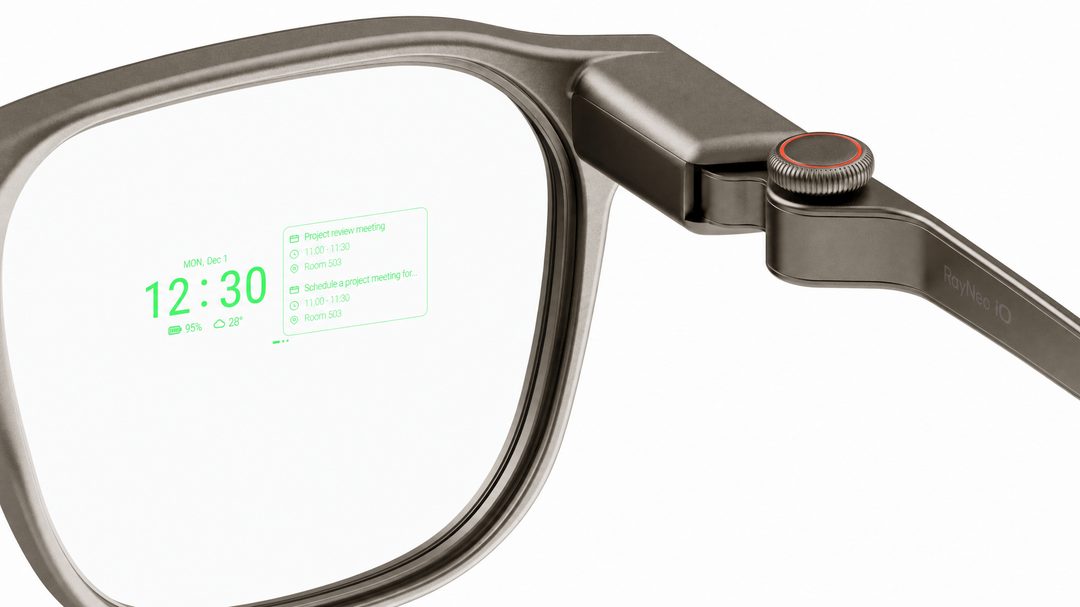
RayNeo 发布新款 AI 眼镜,最大特点是跳过摄像头,聚焦文本叠加等轻交互。摄像头是 AI 眼镜最敏感也最具争议的部件,RayNeo 主动砍掉它,相当于在产品定义阶段就规避了隐私风险。
关键点:这款眼镜把交互收窄到“看”和“听”,而非“记录”和“拍摄”。功能面窄了,但用户的心理门槛也低了。这可能是 AI 眼镜走向大众市场的另一种路径——不做眼睛的替代品,做信息的提示器。
为什么重要:Meta 靠摄像头换功能上限,RayNeo 靠砍摄像头换接受度。在 AI 硬件普遍遭遇隐私质疑的当下,产品团队的取舍比堆参数更能决定市场走势。
原文:The Decoder
免费 App 可检测 Meta AI 眼镜,隐私攻防战升级
一款名为 Zuckoff 的免费应用引发热议,它能让用户检测身边是否有人佩戴 Meta AI 眼镜。该应用出现在隐私担忧持续升温的背景下,但也需要清醒看待:检测能力建立在信号识别基础上,并非万无一失。
关键点是“反 AI 眼镜”这一类工具开始出现。Meta AI 眼镜的拍摄能力让公众担心被无声记录,而检测应用正是这种焦虑的产物。Ars Technica 的评论也指出,这类检测工具并不完美,会存在误报漏报。
为什么重要:可穿戴 AI 设备普及的前提是消除“被监控感”。检测工具的出现倒逼硬件厂商在隐私披露机制上做出改进,否则对抗只会升级。
原文:Ars Technica
Cloudflare Agent Tracing 上线,AI 代理有了追踪器
Cloudflare 推出 Agent Tracing,为 AI 代理提供可观测性能力,支持截断限制等追踪功能,帮助开发者排查 agent 的执行链路。值得注意的是,不同框架的 payload 默认记录策略存在差异,选型时需要评估数据暴露面。
关键点在于:AI 代理的执行是“非确定性”的,传统日志无法还原决策过程。Agent Tracing 这类基础设施解决的是开发者的核心痛点——我的 agent 到底做了什么、为什么这么做。但默认记录策略的差异意味着跨框架迁移成本。
为什么重要:当 agent 从 Demo 进入生产环境,可观测性决定了它是否可控。Cloudflare 将追踪能力前置到网络层,等于承认 AI 代理流量已经是需要治理的基础设施流量。
原文:InfoQ 中文
Claude Code 被曝测试 reduced effort 强度
有用户在 X 上发现 Anthropic 似乎在 Claude Code 中 A/B 测试一个 reduced effort 级别(降低出力程度)。简单来说,这会影响代码代理在完成任务时的“努力程度”:是更积极地补充边界情况,还是只完成最小必要改动。
关键点是这属于产品策略而非模型能力变化。Anthropic 可能正在探索差异化的服务等级,例如为低成本订阅档位降低 agent 的推理消耗。如果该策略成为默认,开发者需要重新校准对 Claude Code 输出的预期。
为什么重要:AI 编程工具的“出力水平”正在成为新的产品调节旋钮。这提示我们:模型的能力上限和用户实际获得的体验之间,隔着一层看不见的产品策略。
原文:X / argofowl
结语: 今天的几条故事背后有一个共同点——AI 产品正在从“能不能做到”转向“怎么控制它做到什么程度”。留给你的问题是:当模型能力趋同,产品策略会成为新的护城河,还是新的争议源?
💭 行业观点
今天行业板块最值得看的一件事:Simile CEO 提出“模拟将成为新的 Scaling Law”,同一趋势也在 Latent Space 的数据中得到佐证。如果说上一轮 Scaling Law 赌的是算力堆叠,这一轮的变量已经变成“用模拟重构数据生成与验证”。这不仅是技术路线之争,更可能重新定义 AI 竞赛的成本结构与护城河。
模拟成新 Scaling Law:Simile 的数字孪生赌注
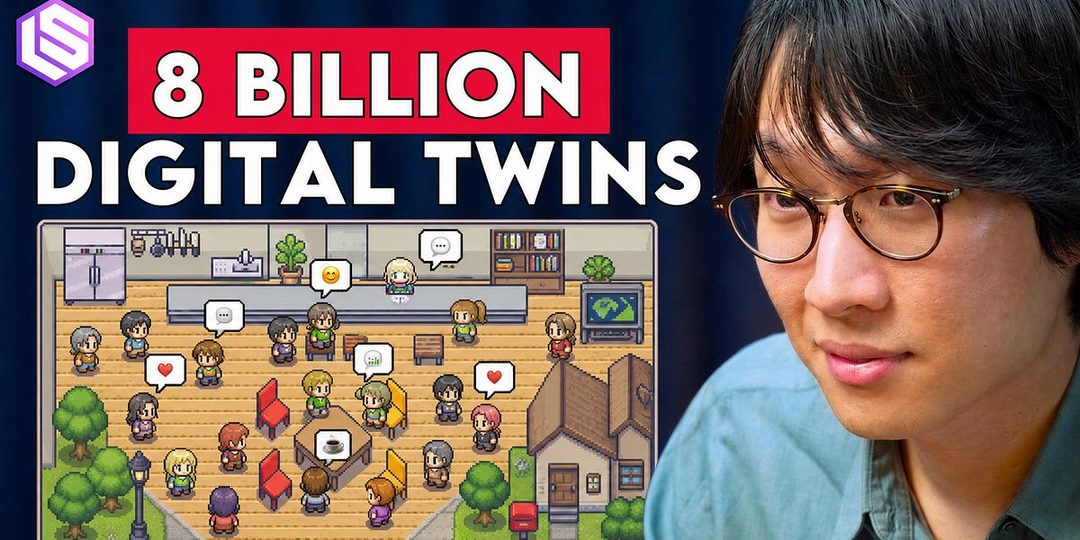
Simile AI CEO Joon Sung Park 讲述从生成式 Agent 到 80 亿数字孪生的历程,明确判断模拟已从探索性研究变成严肃商业,并称之为新的规模法则。其核心逻辑是:现实数据有天花板,而模拟环境可以无限生成、可控标注、按需设计。
关键点在于这不再是学术概念。Simile 把“模拟”作为产品化路径,数字孪生规模达到 80 亿量级,意味着仿真从工具升级为基础设施。对技术管理者而言,这给出一个可追踪的信号:如果模拟数据能替代部分真实数据,现有训练流程的数据预算、清洗成本和合规压力都可能被重新计算。
为什么重要:Scaling Law 如果从“更多算力”转向“更聪明的模拟”,行业竞争焦点将从 GPU 采购转向世界建模能力。
美国施压伙伴国:AI 竞赛必须二选一
美国希望迫使伙伴国家在华盛顿与北京的 AI 竞赛中明确选边,消息来自 the-decoder。这不是技术层面的事,而是地缘博弈的进一步升级。
关键点在于“迫使”二字:AI 不再只是企业间的技术竞争,而成为国家阵营的划线标准。对于跨国企业和投资人,这意味着市场准入、供应链、人才流动都可能被政治标准切断。过去还能两头下注的中间地带正在快速收窄。
为什么重要:AI 的全球化分工体系面临分裂。任何依赖跨境数据、芯片或人才的组织,都需要开始做“选边”压力测试——不是主观意愿问题,而是供应链安全问题。
原文:The Decoder - US wants to force partner countries to choose sides
模拟 10000 倍提速:性能只损失 10%
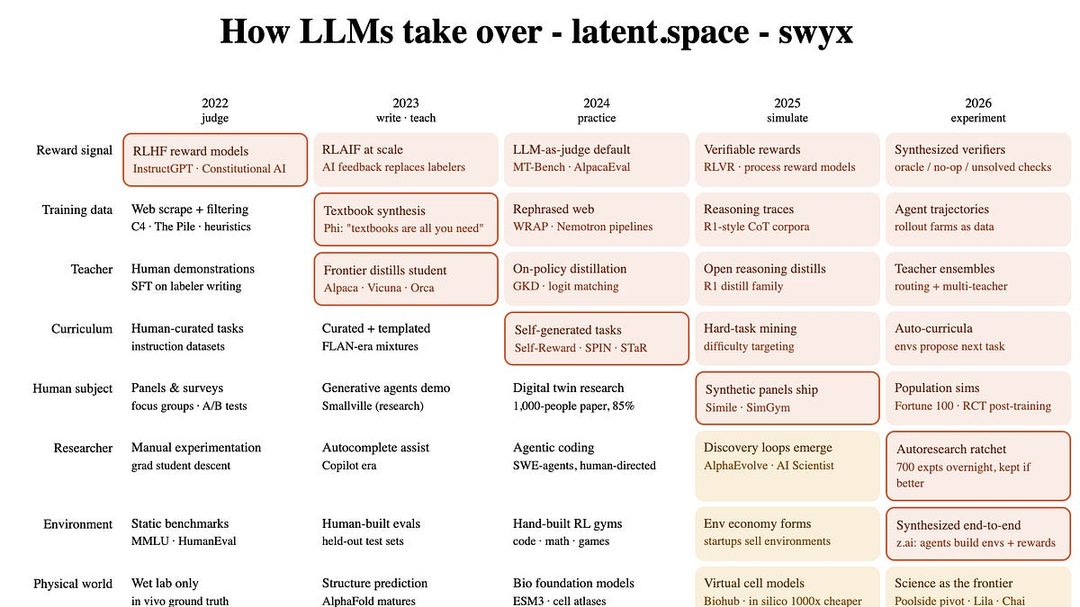
Latent Space 数据显示,模拟方法以 10000 倍速度、100 倍低成本实现仅 10% 性能损失。这意味着“10% 性能换三个数量级的成本优势”成为现实选项。
关键点:模拟的应用范围正在从模型训练扩展到更广泛的工程环节,而不再只是前期数据生成的手段。过去团队担心仿真与真实环境的 domain gap,现在这笔账在成本曲线面前开始划算。
为什么重要:如果一个方案能用 1/100 的成本逼近 SOTA 的 90% 效果,大多数商业场景会选择后者。这会向算力军备竞赛的逻辑发起挑战——不是否定 Scale,而是指出 Scaling 的新方向。
Agent Harness 正在被模型吸收
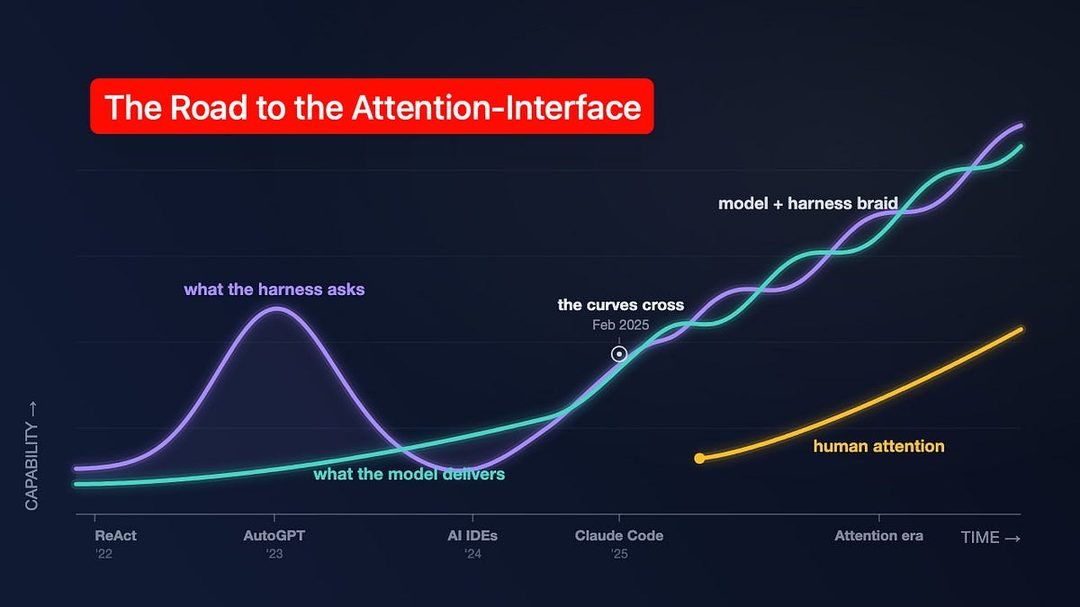
新观点认为,模型正把 agent harness(智能体运行框架)吸收进权重内部,未来真正需要设计的,是面向人类注意力的接口,而非传统意义上的 agent 工作流。
关键点:如果这套判断成立,中间框架层的价值会被模型层蚕食。过去团队花大量精力搭建的 tool calling、记忆管理、任务编排,可能正在变成模型的内生能力。留给开发者的差异点不再是“搭一个 agent”,而是“创造一个让人愿意关注的交互入口”。
为什么重要:技术栈的价值正在上移。对创业公司而言,现在押注底层 agent 框架可能是高危动作,而“注意力接口”会带来新的产品机会。
数据中心本地反对率一年飙至 75%
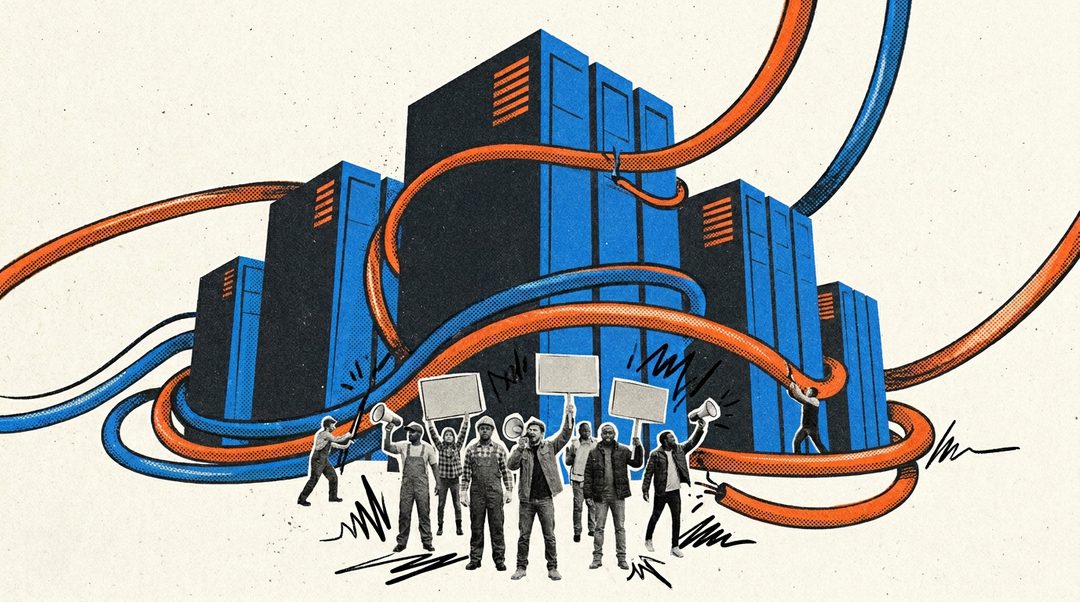
调查显示,民众对在本地建设数据中心的反对率从 42% 升至 75%,仅一年时间。AI 基建扩张正在遭遇更强烈的社会阻力。
关键点:反对率的跳升意味着选址和审批成本将显著增加,这一瓶颈发生在电力、土地、水资源等多重约束之上。基础设施的“社会许可”正在成为新的稀缺资源。
为什么重要:如果算力供给因社区阻力而延迟,即便模型技术领先,商业化落地节奏也会被拖慢。对 IDC 运营方和云厂商来说,这不仅是公关问题,更是交付时间表问题。
原文:The Decoder - Data center opposition surged from 42% to 75%
Anthropic 光环消退:AI 圈信仰开始转移
InfoQ 文章讨论 Anthropic 不再被视作 AI 圈信仰,并探讨信仰正在发生转移的方向。文章没有给出单一归因,而是梳理了多重因素。
关键点:AI 圈的“信仰”从来不只是技术评价,更是人才流向、投资估值和生态合作的风向标。当一家公司失去信仰地位,影响不限于其自身——整个安全派叙事的影响力也在被重新定价。
为什么重要:技术社区的情绪变化往往领先于基本面。如果你在关注 AI 生态格局,Anthropic 光环消退的信号值得进入决策视野,尤其是涉及人才招聘和合作伙伴选择时。
Vercel Zero 引争议:AI 时代需要新语言?
Vercel Zero 发布引发讨论:AI 时代还需要一门专门的新编程语言吗?支持者认为现有语言携带太多历史包袱,质疑者认为问题不在语言而在工具链。
关键点:这不仅是语言之争,更是对 AI 生成代码范式的反思。如果 AI 承担主要编码工作,“为 AI 设计”的语言接口会比“为人类设计”的语言更值得关注。
为什么重要:编程语言的生态迁移成本极高,但如果 AI 真的改写编码方式,语言层的洗牌窗口可能比预期更早打开。
人才断层:下一代高级工程师从哪来?
文章指出初级岗位消失、高级人才断层,AI 正在重塑工程师培养路径。问题的核心不再是“AI 会不会取代工程师”,而是“没有了初级岗位,高级工程师如何成长”。
关键点:传统培养路径依赖“从初级到高级”的进阶,而 AI 工具正在抽掉这个台阶。行业面临的是一个时间错配问题:当前的高级工程师会逐渐退休,而新一代缺乏系统成长通道。
为什么重要:人才断层是比技术更慢、更难逆转的瓶颈。对 CTO 而言,内部培养体系和 AI 时代的师徒机制设计,将比招聘竞争更能决定长期工程能力。
当模拟既便宜又快,AI 竞赛的胜负手可能不再是谁的 GPU 多,而是谁更擅长构造可信的虚拟世界。留给读者的问题是:你所在的组织,开始用模拟替代真实数据了吗?
⚙️ 开源工具
今天开源圈最值得关注的变化,不是某个模型发布,而是围绕 agent 的工程化组件开始密集出现:Apache Maka 把 agent 运行日志做成可审计的 append-only 记录,腾讯开源全栈红队测评工具,火山引擎则将记忆与 RAG 统一到一张自进化上下文表。加上 llm 0.33 对 OpenAI 3.x 的适配,一个信号越来越清晰——agent 正从演示走向可部署、可观测、可评测的工程系统。
Apache Maka 孵化:agent 运行的审计日志终于有了标准做法
Apache 基金会新孵化项目 Maka 定位为本地优先、可审计的 AI agent 工作区。核心机制是用 append-only 日志记录 agent 的模型消息、工具调用和权限决策,这意味着每一次 agent 的行为都有不可篡改的痕迹,排障与合规审查有了抓手。
关键点在于“append-only”这个设计选择:日志只能追加、不能修改,天然适配安全审计场景。相比常见 agent 框架把运行状态放在内存或可变数据库中,Maka 的方式更接近事件溯源架构,为 agent 行为回溯提供了可验证的路径。
这件事的意义在于补上了 agent 工程化的关键短板——可观测性。此前 agent 出错时,开发者很难判断是哪一步工具调用或权限判断导致的偏差。Maka 若能借 Apache 社区之力成为标准接口,agent 的调试、监控、合规将拥有统一的底层基础。
腾讯开源 AI-Infra-Guard:红队测评工具首次覆盖全栈
腾讯今日开源 AI-Infra-Guard,定位为全栈红队测评工具,覆盖 Agent、Skills、MCP(Model Context Protocol)、AI 基础设施扫描与 LLM 越狱评估。从单点模型测试到完整基础设施体检,一次给出安全画像。
关键点在于覆盖面:此前的越狱评估多停留在模型对话层,AI-Infra-Guard 则延伸到 MCP 与 Skills 这两层 agent 的新攻击面。当 agent 开始调用外部工具,工具链本身就可能成为注入入口,这一块的测评此前几乎是空白。
对技术决策者而言,这提供了一份 agent 上线的安全检查清单。安全问题正在从“模型有没有毒”变成“整套 agent 系统有没有漏洞”,腾讯把内部红队能力开源,等于给行业发了一份可执行的安全基线。
火山引擎 OpenViking:把 agent 记忆做成自进化数据库
火山引擎开源 OpenViking,官方定位是“自进化上下文数据库”,将 Agent 记忆、知识 RAG 与 Skills 统一到同一套存储与检索体系里。这意味着 agent 的短期会话、长期偏好、领域知识不再分散在多个组件中。
关键点在于“自进化”——系统根据对话结果自动调整上下文组织方式,而非靠人工配置固定的检索策略。这一设计与近期 agentic 系统强调“在运行中优化自身工作流”的趋势一致,把记忆从静态缓存变成了动态知识资产。
为什么重要:记忆与知识管理一直是 agent 落地的瓶颈。无论是个人助理还是企业知识库场景,碎片化的上下文常常让 agent 表现不稳定。OpenViking 试图用一套数据库语义同时解决 RAG 与记忆问题,如果效果达标,agent 开发的架构复杂度将显著下降。
llm 0.33 发布:OpenAI 3.x 时代,CLI 老将完成适配
Simon Willison 的 llm CLI 发布 0.33,核心变更为升级 OpenAI Python 库至 3.x 并重构底层 HTTP 客户端;0.32.1 修复了安装问题,llm-openrouter 0.7 完成同步适配。对依赖该工具链的开发者而言,这是一次必做的兼容性升级。
关键点在于重构方向:新 HTTP 客户端意味着请求管理与错误处理的方式有变,插件生态需要相应跟进。llm-openrouter 的同步适配,说明主流模型路由插件已就绪,开发者可以放心升级到 3.x。
从生态位看,llm 一直是命令行调用大模型的标杆工具。它的版本迭代节奏往往映射整个 Python 生态对 OpenAI SDK 的迁移进度。对于维护相关工具链的开发者,这次发布提示一个时间节点:OpenAI 3.x 已全面落地,旧版兼容问题该清扫了。
Superpowers 开源:一套拿来即用的 coding agent 方法论
obra/superpowers 提供一套基于可组合技能的 coding agent 方法论与框架。它不是单一工具,而是一组设计模式加实现,目标是让开发者用搭积木的方式构建自己的 agent 能力。
关键点在于“可组合技能”——将复杂任务拆成可复用、可插拔的 skill,agent 按需调用组合。相对端到端的黑盒 agent 产品,这种方式让开发者保有对行为的控制权,调试和替换都更直接。
在 agent 能力快速膨胀的当下,可维护性正成为核心问题。Superpowers 的价值在于提供了一套提高开发效率的路线图,而非又一个封闭框架。对于正在自建 agent 的团队,它值得作为参考设计材料研读。
MoneyPrinterTurbo:AI 短视频进入“一句话生成”时代
MoneyPrinterTurbo 利用 AI 大模型与自动化工作流,根据主题或关键词一键生成高清短视频。从文案、配音到画面剪辑全部自动化,把内容生产的边际成本压到极低。
关键点在于一键生成背后的自动化流水线:从话题理解到分镜脚本、素材匹配、语音合成、字幕与背景音乐合成,整条链路无人值守。对于批量内容生产场景,这套流程的效率远超人工剪辑。
对一个内容平台而言,这类工具正在重写供给曲线。当视频生产成本趋近于零,内容竞争将彻底转向选题与判断力,而非制作本身。对于关注 AI 应用的读者,这既是效率工具,也是内容行业的一个变量信号。
vLLM:高吞吐推理引擎为何持续霸榜
vLLM 以高吞吐、内存高效著称,是开源社区最活跃的 LLM 推理与服务引擎之一。它通过 PagedAttention 等机制大幅提升 GPU 利用率,让同一批硬件跑更多请求。
关键点在于吞吐与内存的平衡:PagedAttention 借鉴操作系统虚拟内存分页思路,减少 KV cache 碎片,使得长上下文与并发场景下的资源利用大幅改善。这是其在生产环境中被广泛选用的技术根基。
对部署团队来说,vLLM 已是事实上的服务层标准之一,社区活跃度意味着新模型适配最快、Bug 修复最及时。如果正在规划推理基础设施,它仍是值得首先评估的引擎。
ruflo 开源:Agent 元框架与多智能体 swarm 的一次打包
ruflo 定位为 agent meta-harness,宣称支持多智能体 swarms、自适应记忆、自学习智能与 RAG 集成。它试图在一套框架内覆盖 agent 开发的多个高阶需求。
关键点在于“meta-harness”这个定位——它不绑定具体 agent 实现,而是提供编排层能力,让多个 agent 协作、共享记忆并接入知识库。多智能体协同与自适应记忆都是当前 agent 领域的前沿方向,ruflo 将之一并打包。
需要保持谨慎的是,多智能体框架常有过度工程化的风险。若稳定性和文档跟上,ruflo 可作为研究多种复杂特性的参考实现;团队若要落地使用,建议先小范围验证。它的重要性仍在积累中。
今天开源社区最一致的信号是:agent 不再是单点模型调用,而是一整套可审计、可测评、可记忆的工程系统。留给读者的问题——你为 agent 上生产环境,准备好安全清单了吗?