今天最值得看的三件事:
- 模型发布 · Anthropic 发布 Claude Fable 5.1:编程霸榜,成本最高降 45%
- 模型发布 · OpenAI 披露首个“关键网络能力”级模型 Astra
- 模型发布 · Google 发布 Gemini 3.8 Flash,六周内第三款轻量模型
下文按板块展开,正文每条均附原始链接。
🚀 模型发布
🏢 公司动态
🔬 研究论文
今天研究板块里最值得关注的事,是蚂蚁集团的 OmniTable 拿到 VLDB 2026 工业赛道最佳论文。它真正的信号不在于”获奖”,而在于大模型竞赛的底层战场正在从模型架构向数据工程迁移——当所有人都在卷参数和推理时,谁掌握了对海量语料的高效清洗能力,谁才握有下一轮训练的入场券。
蚂蚁 OmniTable:统一宽表,让 35PB 语料变得可用
是什么: 蚂蚁集团提出一套名为 OmniTable 的统一宽表系统,专门面向大模型语料清洗场景。该系统已实际支撑 35PB 级别的数据处理,官方称效率提升达 5.6 倍。凭借这一工程成果,OmniTable 摘得 VLDB 2026 工业赛道最佳论文。
关键点: 语料清洗向来是大模型训练中最脏最累的环节。OmniTable 的巧妙之处在于把异构、碎片化的原始数据统一为”宽表”结构,让清洗任务可以像查表一样被批量执行和调度,绕过传统 ETL 流程中反复读写带来的性能损耗。效率提升的 5.6 倍来自底层存储与计算语义的打通,而不只是并行度的堆砌。
为什么重要: 大模型竞争的上半场拼的是架构创新,下半场拼的是数据供给的质量与成本。35PB 的体量意味着 OmniTable 经过了真实工业环境的检验,而非实验室里的 benchmark 玩具。对产业界而言,这套系统的思路或将成为大规模语料处理基础设施的标准范本。
原文:量子位
AWS 发布 Aws-Bench:给云上 Agent 一把度量尺
是什么: AWS 推出名为 Aws-Bench 的基准测试,专门用于评估大模型 Agent 在真实云任务中的执行能力。它不是又一个聊天机器人排行榜,而是把评测场景直接搬到了云基础设施的操作层面。
关键点: Agent 在云上干活,比的是工具调用、流程编排、异常处理和权限判断的综合能力。Aws-Bench 的设计目的是让模型在接近真实的生产任务中接受检验,而不是停留在 API 调用或静态问答的层面。云厂商亲自下场做基准,意味着 Agent 的应用范式正从”对话”转向”操作”。
为什么重要: 云是 Agent 商业化落地最肥沃的土壤,但同时也是容错率最低的场景——一次误操作可能带来真金白银的损失。AWS 用一套自己的考核标准来定义”好 Agent”,既是对自身云生态的绑定,也是在争夺 Agent 评测标准的话语权。任何想在云上做 Agent 的团队,都该看看这把尺子的刻度。
原文:InfoQ
BenchMIRT 拷问:LLM 基准到底在测什么?
是什么: Hugging Face 联合研究团队发布 BenchMIRT 分析报告,试图回答一个基础却尖锐的问题:现有 LLM 基准是否真的测出了模型能力,还是只测出了一堆与能力无关的噪声?
关键点: 我们习以为常的 benchmark——从 MMLU 到 HumanEval——真的在测”智能”吗?BenchMIRT 的出发点正是质疑这种惯性认知,尝试拆解基准分数中哪些来自模型本身的泛化,哪些来自数据泄露、题目记忆或测试集污染。这项工作是对评估评估者的一次元层面的审视。
为什么重要: 整个行业都在看 benchmark 数字说话:刷榜、调 prompt、凑分数——这些行为已经扭曲了基准原本的意义。BenchMIRT 的价值在于提醒大家:如果连尺子本身都不可信,那我们依据这些排名做出的模型选型和研究判断,根基到底稳不稳?对技术决策者来说,意识到基准的边界,比追逐更高的分数更稀缺。
当语料工程成为基础设施、Agent 开始操作真实系统、而基准本身的可靠性被提出质疑,算力的故事讲完后,衡量智能的标尺或许比智能本身更值得留意。
📱 应用产品
💭 行业观点
今日最值得关注的是美国政府在 OpenAI 版权案中介入表态:用版权材料训练大模型可视为合理使用(fair use)。这一立场若被法院采纳,将改写 AI 训练数据的法律风险地图。它不仅是法律判断,还是产业政策——白宫已明确要把 AI 全球竞争力放进天平。
美国政府站到 OpenAI 一边
是什么:在针对 OpenAI 的版权诉讼中,美国政府以意见书形式支持 OpenAI,明确主张用版权材料训练大模型属于合理使用。
关键点:政府没有停留在法律解释,而是把经济与地缘竞争摆上台面——认为这一立场符合美国 AI 产业的全球竞争利益;若法院采纳,将显著降低 AI 公司在训练数据层面的法律风险。
为什么重要:这是行政机关在版权案中给出清晰立场,可能成为后续同类案件的参照系。它也暴露了创作者权益与国家产业目标之间的直接张力:谁有权利定义“合理性”,结果将由法院和产业政策共同决定。
原文:TechCrunch
DeepMind 新负责人:前沿 AI 领先是唯一命题
是什么:Google DeepMind 新任负责人表态,前沿 AI 领导力是唯一重要的事,公司资源将集中于此。
关键点:这不是抽象宣言,而是对 AI 竞赛格局的重新校准:一旦模型代差形成,后续应用、人才和资本都会向领先者倾斜,因此内部优先级必须更聚焦。
为什么重要:DeepMind 在 Google 体系内一直被寄予“探索边界”的期望,如今目标变得更明确。对研究社区而言,这意味着能直接支撑前沿模型领先的方向,可能获得比长远基础研究更优先的资源。
原文:The Decoder
白宫被诉:前沿 AI 安全测试规则不能暗箱
是什么:一项诉讼指控特朗普政府隐瞒用于前沿 AI 模型的安全审查规则,并质疑这种秘密审查可能隐藏腐败空间。若法院支持原告,可能强制公开相关规则。
关键点:核心不是某个模型或公司,而是政府审查的透明度。规则不公开,外界就无法评估安全测试是否被政治或商业利益左右。
为什么重要:前沿 AI 的安全治理正在与行政保密文化正面碰撞。即使这次诉讼未能迫使白宫全盘公开,围绕监管规则合法性的质疑也会持续增加。
原文:Ars Technica
AI 检测“金标准”的误判风险
是什么:AI 检测平台 Pangram 在出版、招聘等领域已成为事实标准,其判断足以影响一篇文章能否发表、一个候选人能否获得工作。
关键点:单一检测工具被赋予过高裁决权,误判代价往往由个人承担。与此同时,Pangram CEO 警告互联网正接近“死亡”——合成内容快速膨胀,反而让检测这件事本身越来越难。
为什么重要:当“文本是否由 AI 写出”变成量化指标,少数公司的模型就掌握了新的社会权力。虚假阳性率、申诉渠道和检测的公开验证,不能再被当作纯技术问题回避。
原文:Wired
Anthropic 向监管与媒体开放检测工具
是什么:Anthropic 将 Claude 的文本水印与 AI 检测能力,开放给监管机构、媒体和事实核查组织。
关键点:这不是面向普通用户的消费品,而是向需要判断内容可信度的机构提供“公共接口”。开放的指向很明确:让 AI 内容不只依赖企业自证,而是可以外部验证。
为什么重要:AI 内容透明度正在从公司自主披露,走向可审查、可审计的流程。下一步的关键问题是:水印与检测系统能否通过独立测试,而不只是开放姿态。
原文:The Decoder
开源项目越来越像 AI 驱动的软件工厂
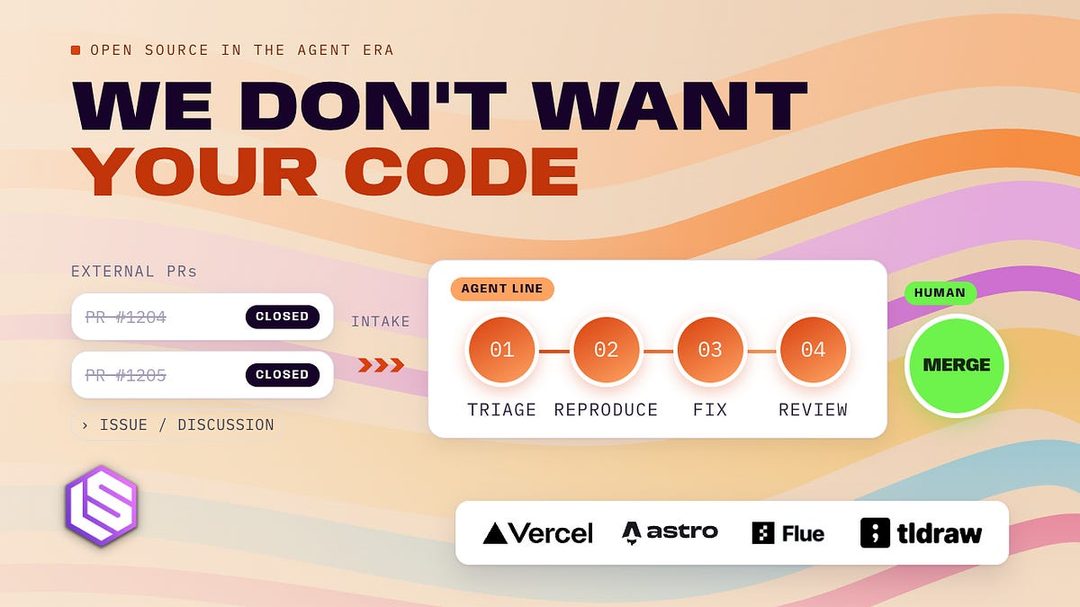
是什么:以 Vercel AI SDK 为代表的头部开源项目,正用 Agent 团队替代零散社区贡献,把补丁和功能交付变成流水线作业。
关键点:开源协作的旧假设被改写——贡献不再靠随机涌现,而是被集中、流程化地生产;质量控制和所有权都更明显地向项目维护方回归。
为什么重要:如果领头的开源项目都转向“软件工厂”模式,开源会变得更像商业产品发布,而不是共同开发。社区成员的参与意义与激励结构,将随之发生根本变化。
原文:Latent Space
特朗普:数据中心抗议等于帮中国
是什么:特朗普将美国国内反对 AI 数据中心的抗议,直接与中美科技竞争挂钩,称相关抵制行为会削弱美国优势。
关键点:这一叙事把地方层面的能源、土地和环保争议,上升为国家安全议题。本地抗议者因此被置于“帮对手削弱美国”的话语压力之下。
为什么重要:AI 基础设施正在被嵌入地缘政治叙事。未来围绕数据中心的每一次地方性抵抗,都可能被重新定义为战略风险,公共讨论空间会因此收窄。
原文:The Decoder
今天所有故事都在争夺同一样东西:AI 时代“规则解释权”的合法性,政府、法院、平台与开源社区各占一角。值得追问的是,如果合理使用成了默认答案,谁还拥有对 AI 说“不”的能力?