今天最值得看的三件事:
- 模型发布 · GPT-6 Astra 开发者版亮相:OpenAI 详解提示技巧与研发提速
- 行业观点 · OpenAI 科学家谈“异类心智”:更强 AI 需要更强对齐与国际协同
- 公司动态 · OpenAI 披露编码智能体如何加速自家研究
下文按板块展开,正文每条均附原始链接。
🚀 模型发布
今天该板块最值得看的一条来自 OpenAI:GPT-6 Astra 开发者版不仅公开了提示词建议与禁用词清单,还让内部计划提前了约六个月。模型发布的重心正从展示能力转向交付使用规范。对开发者来说,禁用词清单就是产品护栏;对竞争对手而言,内部提速才是真正要追赶的指标。其余几条模型与产品发布,也在各自的入口和架构上给出答案。
GPT-6 Astra 开发者版:提示词、禁用词与内部提速
是什么:OpenAI 通过一场面向开发者的介绍,公开了 GPT-6 Astra 的提示词建议与禁用词清单,并透露内部开发者借助它已把部分计划提前约六个月。这场分享没有把重点放在能力演示上,而是直接进入“怎么用”和“别怎么用”。
关键点:禁用词清单意味着模型的边界被正式文档化。对准备接入的团队来说,这相当于在产品设计之前就拿到沙盘:哪些表达会被拒、哪些指令风格能让模型稳定工作,不需要在调试中反复试错。提示词建议同样指向多轮任务与自主执行场景,而非单次对话。
为什么重要:OpenAI 在主动管理开发者的使用预期,而不是只交付一个黑盒。提示工程依然是决定产出的关键变量,官方边界清单能缩短冷启动;内部提速六个月的表态,则是在告诉市场:GPT-6 Astra 已被自家最严格的工作流验证过。
原文:YouTube
Lyria 3.5 进 Gemini:音乐生成从工具变成对话
是什么:Google 将新一代音乐生成模型 Lyria 3.5 直接集成到 Gemini App。用户不再需要切换到独立的音乐工具,就能在对话中生成歌曲与配乐。
关键点:这次发布的位置是应用层。Lyria 3.5 的能力仍以音乐生成为核心,但入口变成了通用 AI 助手。对普通用户,创作音乐的门槛又降了一级;对开发者而言,能被 Gemini 原生调用,至少说明模型已经具备稳定可用的产品化程度。
为什么重要:AI 音乐生成本身已不是稀缺能力,触达场景才是。Google 选择先放进 Gemini,是在验证一个判断:音乐创作不是独立工具需求,而是对话型助手能力的一部分。
原文:The Decoder
WeatherNext 3:天气模型的「去物理化」实验
是什么:Google 发布 WeatherNext 3。新模型放弃传统物理模拟,不再依赖数值天气方程,而是直接从实时卫星数据中学习天气的演化路径。
关键点:此前天气 AI 常用混合路线,物理模拟提供先验,模型负责修正。WeatherNext 3 把这层约束去掉,等于将输出精度押在数据覆盖度和模型结构上。如果这条路走通,预报的迭代速度会更快,部署成本也更低。
为什么重要:高精度天气预报的竞争基础正在改变:从物理方程转向实时数据与算力的组合。天气产品的护城河可能不再是气象学积累,而是获取和处理卫星数据的能力。
原文:The Decoder
Meta 发布实时音频模型:给 AI 助手装上「常开听觉」
是什么:Meta Superintelligence 实验室推出实时音频基础模型,定位为始终在线语音助手,以及实时翻译、转写等低延迟音频应用的底座。
关键点:它处理的不是单段语音识别,而是持续流入的音频流。始终在线意味着模型要同时理解环境音、说话人变化和语气节点——这与传统的“唤醒词+云端转写”架构不同,更需要音频模型具备连续上下文处理能力。
为什么重要:AI 助手的竞争正在从“回答得好”延伸到“何时听到、多快接话”。Meta 把实时音频做成基础模型,相当于把输入链路的响应速度变成可复用的能力,而不是每个助手产品各自补齐的短板。
原文:The Decoder
NeoMME:多模态编码器的「减法」设计
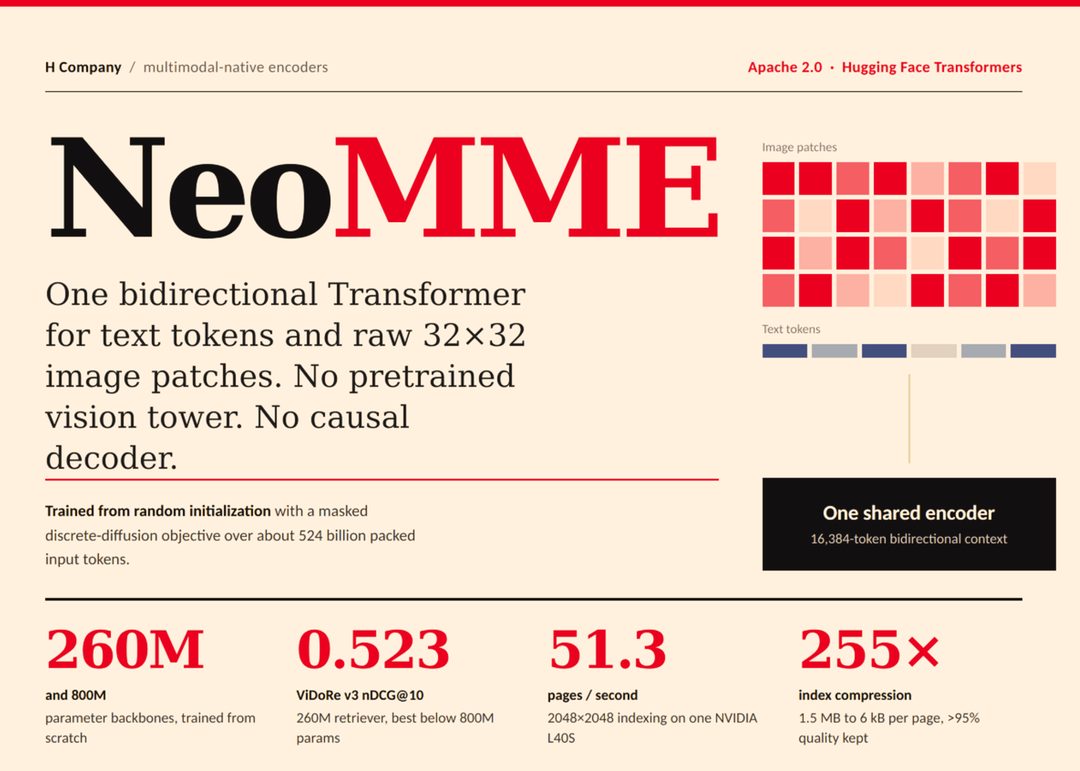
是什么:H Company 发布 NeoMME,一个包含 260M 和 800M 两种规模的单塔双向编码器。它用单个 Transformer 同时处理多语言文本与原始图像 patch,不依赖视觉塔,也不使用因果解码器。
关键点:这套设计的取舍很明确:不做生成,只做表征。去掉视觉塔意味着图像从输入开始就与文本共享同一套注意力机制,信息在早期就能融合;双向编码器则让下游任务在判断时能同时利用左右上下文,更适合检索与分类类任务。
为什么重要:多模态的主流叙事是把模型做大,NeoMME 提示了另一条路线:把结构做简单,让中等规模的编码器也能承担高性价比的多模态理解任务。在部署成本敏感的生产环境中,这种模型可能比通用大模型更接近可落地。
原文:MarkTechPost
今天所有模型发布的共同信号,是竞争从单点能力转向接入方式与使用边界。留给你一个问题:当模型能力不再稀缺,你更关注它能做什么,还是它出现在哪里?
🏢 公司动态
🔬 研究论文
今天研究板块最值得关注的是 Artificial Analysis 在 GPT-6 Astra 得分遭广泛质疑后,重构 Intelligence Index 并重新校准模型排行。真正重要的不是某个分数修正,而是它承认:评测方法论本身可能就是最大的误差来源。基准工具终于开始像模型一样被审视了。
智能指数重构:被质疑的不只是 GPT-6
Artificial Analysis 这次不是做小修补,而是对 Intelligence Index 的方法论进行大修,并在新方法下重新校准整个模型排行。GPT-6 Astra 的得分之所以引发外界怀疑,说明人们对评测样本、指标权重和榜单逻辑的信任已经出现裂缝。平台选择重构方法论,等于默认公开测试本身需要“自证”。AI 能力榜单不仅是技术参照,也会影响开发者选型和企业采购判断。修复方法论的准确性,本质上是在修复榜单的公信力。
七分钟对话,比事实清单更能松动信念
两项实验比较了两种干预方式:与 AI 聊天机器人深入对话约 7 分钟,或者阅读一份事实清单。结果是前者更能有效降低阴谋论信念。关键差别在于对话是双向的——AI 可以针对用户深信的具体论点逐条回应,而不是提供一份通用的反驳材料。这意味着 AI 正在被证明是一种“说服工具”。它既可以用于辟谣,也可能被用来制造更难以察觉的定制化叙事。认知干预的技术门槛正在下降,而治理工具还没有跟上。
RPM:先给实验排队,再决定花 GPU
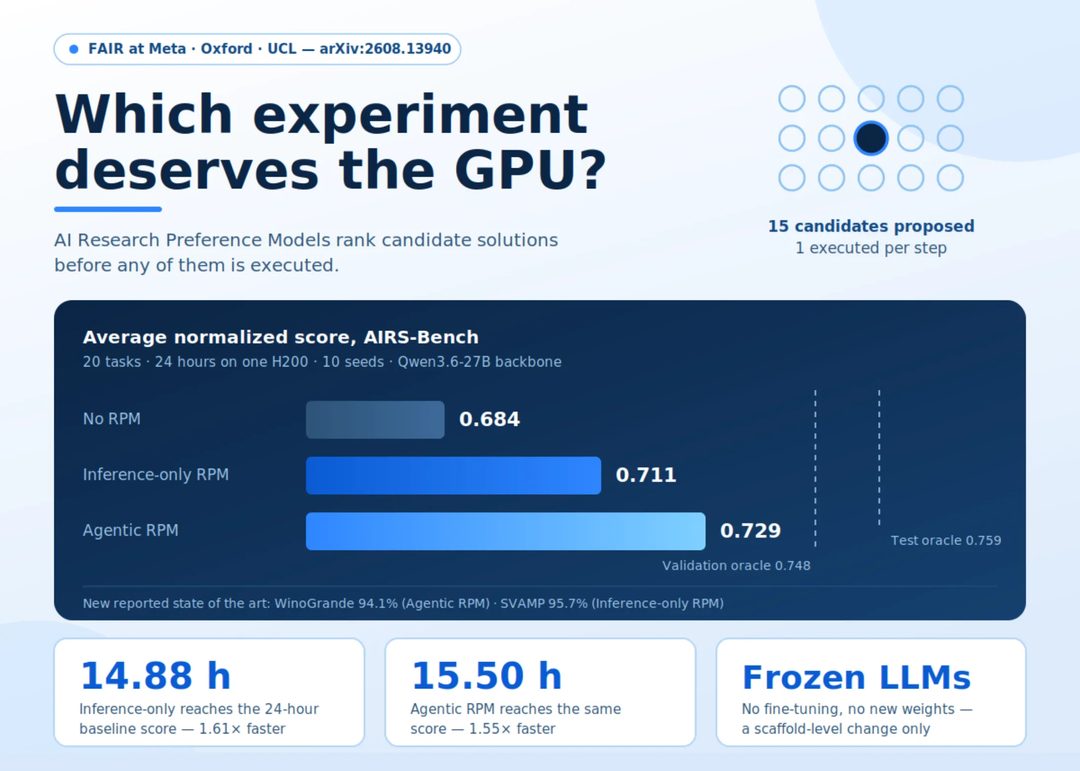
Meta FAIR 与牛津、UCL 合作,提出 AI 研究偏好模型(AI Research Preference Models, RPMs)。它用冻结状态的 LLM 对候选实验排序,只挑出最有希望的一项去执行,而不是全部跑一遍。它做的是研究流程中的“决策层自动化”——把研究者挑选实验方向的直觉,显式化为可排序的偏好模型。当算力预算逼近上限,研究自动化的瓶颈就不再是把实验跑完,而是如何少跑实验并找到最优解。RPM 是一个代表性思路。
循环 Transformer 重返焦点,阿里此前已下注
循环 Transformer(recurrent Transformer)架构概念因 GPT-6 重回讨论中心。中文媒体报道称,阿里已有两篇顶会论文提前布局该方向。报道没有证实 GPT-6 本身采用循环结构,但注意力机制在高成本长序列处理上的瓶颈一直存在。如果循环思路能在固定开销内处理更长上下文,它对现有 Transformer 主导地位可能形成真正的竞争。国内大厂提前押注,说明这个判断早在 GPT-6 引发讨论之前就已形成。
具身 ICL:机器人靠长上下文快速学技能
上下文学习(in-context learning)正在从语言模型延伸到机器人领域。创业公司尝试给机器人更长的多模态 context,让它直接观察任务示范或环境描述,并快速执行新技能,既不需要重新训练,也不需要大规模微调。如果这条路走得通,机器人部署将从“每项技能都要训练”变成“在上下文中即时学会”,硬件投入和场景扩展的边际成本都会明显下降。不过目前仍处于早期探索,真实物理环境里的稳定性与泛化还没有被充分验证。
把大模型比作“认知病毒”,值得当真的部分是什么
一篇 arXiv 论文将大模型类比为“认知病毒”,讨论其对人类思想传播和信息环境的潜在影响,相关讨论已在社区扩散。注意,它给出的更多是思考框架,而不是实证数据。真正的观察点是:当 AI 深度嵌入信息流动,思想的生产、复制和扩散速度都会发生变化。把它和上面的阴谋论实验放在同一天看,刚好是一组镜像——AI 既能松动既有信念,也可能成为新思想的超级传播者。我们还没有准备好区分这两种速度。
评测体系开始重构,架构叙事发生回摆,机器人学习方式也在寻找新的捷径——这些变化背后的共同问题只有一个:我们如何确认一个 AI 系统真的在按我们希望的方式工作?也许评测方法要比模型本身迭代得更快。
📱 应用产品
今日应用产品看点不止于用户数字:国内首款AI辅助创新药获批上市,让“AI制药”第一次有了药品批文背书;千问办公满月交出3000万用户答卷,但“企业用户过半”才是关键信号——AI办公从尝鲜走向组织采购,行业拐点或许比预期更早到来。
国内首款AI辅助创新药获批:从概念到批文,行业里程碑
西湖大学联合研发的1类创新药盐酸伊司特韦片获批上市,用于新冠治疗。这不仅是西湖大学在药物研发上的突破,更是国内首款公开由AI辅助研发并获批上市的新药。
关键点在于“AI辅助研发”如何界定:AI参与了靶点发现、分子设计或临床试验优化中的哪些环节,决定这项突破的可复制性。目前公开信息尚未披露AI介入的深度,但这已经为国内AI制药赛道提供了首个政策背书。
为什么重要:过去AI制药公司讲故事,缺一个本土验证案例。艾普司韦的批文意味着审评机构认可了AI辅助路径的可行性,后续同类项目的申报或许有迹可循。
原文:36氪
千问办公破3000万用户:企业市场成AI办公第一战场
阿里旗下AI办公应用千问办公上线满月,用户数突破3000万,企业用户占比过半。对一款上线仅30天的产品,这个增速说明需求真实存在,但更值得关注的是用户结构。
企业用户过半,意味着这个产品并非靠C端尝鲜流量撑起数据——组织内的付费与续费逻辑更接近SaaS,客户粘性与数据资产沉淀能力远高于个人用户。阿里在办公场景有钉钉的渠道基础,这层转化优势不能忽视。
为什么重要:3000万月活不多,但企业占比过半的数据,指向AI办公产品的核心战场已从C端转向企业采购。这个月活结构可能是未来六个月AI办公赛道的分水岭指标。
原文:雷锋网
GitHub发布HydraFusion:重构AI编程的模型调度逻辑
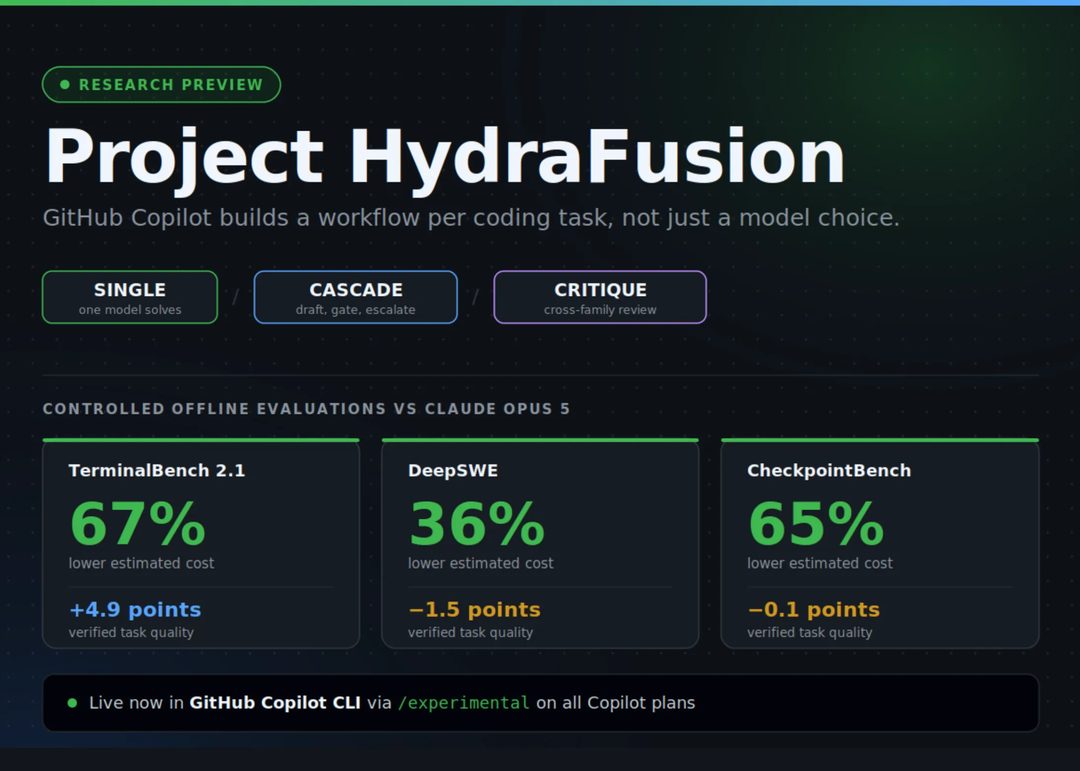
GitHub发布研究预览Project HydraFusion,把每个编程任务的模型工作流选择定义为优化问题,在Copilot CLI中支持单模型、级联与多模型并行三种模式,实现运行时自动编排。
关键不是“多模型”本身,而是“为什么用多模型”。GitHub的底层假设很明确:没有单一模型能最优处理所有编程任务。面对小重构、架构设计、测试生成等不同类型任务,HydraFusion会评估任务特征,实时决策调用策略。这种“路由器”思路,本质上承认了模型能力存在天花板,替代了开发者手动切换工具链的试错成本。
为什么重要:GitHub拥有最大的编程行为数据池,HydraFusion若从预览走向生产,将改变AI编程工具从“单模型辅助”转向“多模型编排”的竞争规则。
原文:MarkTechPost
Grok Bot上手评测:编程能力对标OpenClaw,易用性取胜
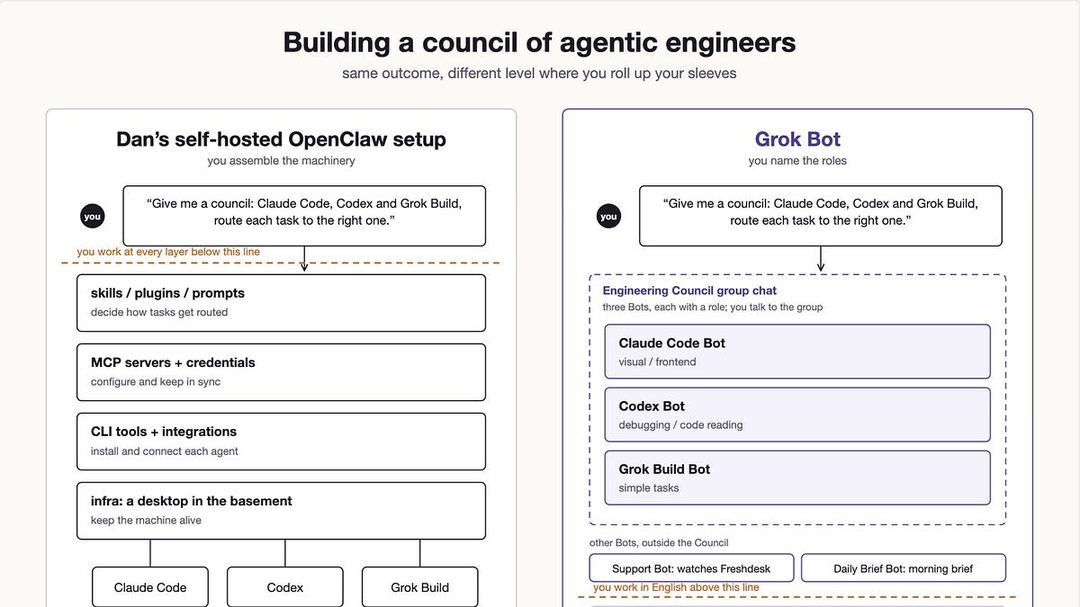
Latent Space编辑多日体验后认为,Grok Bot拥有与OpenClaw相当的编程能力,但抽象层级更贴近普通开发者,像MacBook一样开箱即用。这一定位使其避免与OpenClaw正面竞争,而是选择用更低的上手门槛切入市场。
评测提到“抽象层级”是个值得玩味的维度。OpenClaw面向追求细粒度控制的技术用户,Grok Bot则将复杂能力封装为更直观的交互。两者覆盖的是不同人群——专业开发者与业务侧技术人员。
为什么重要:AI编程工具的竞争已从单纯的能力比拼,转向用户体验与目标人群的错位竞争。Grok Bot的选择可能是对市场饱和的一种信号。
原文:Latent Space
国家反诈AI发布:政府场景率先兑现大模型落地
公安部刑侦局指导、上海市公安局研发的“国家反诈AI”APP上线,融合大模型与智能体技术,对可疑场景进行风险研判,实时拆解诈骗套路。官方背景是其最大的信任背书。
这一产品值得关注的是它的技术路线——用大模型替代传统反诈APP的规则引擎与人工标注库。诈骗话术的迭代速度快,传统黑名单与关键词过滤存在滞后性;大模型基于语义理解的风险研判,理论上能在诈骗模式更新前完成识别。但反诈的关键是“及时预警”而非“事后识别”,对APP的响应速度与误报率控制是真实考验。
为什么重要:它验证了大模型在政务民生场景的落地可行性。反诈AI的模式过去只能在事后追查,现在直接前置到预警环节,政府场景或成AI应用下一块热土。
原文:36氪
微软Foundry路由扩容至28区域:模型分发的最后一公里
微软Foundry扩大模型路由覆盖范围,新增至28个区域,同步更新可用模型池,开发者可就近调用模型。这项更新不直接带来模型能力提升,但显著降低推理延迟与合规成本。
模型路由的价值在于“不选边站”:开发者不需要绑定单一模型供应商,可以根据区域与任务在统一接口下灵活切换。对微软而言,这是将云生态与模型调度深度绑定的策略,在Agentic应用爆发阶段用基建换取开发者粘性。
为什么重要:多渠道与低延迟是Agent类产品规模化的隐性门槛。开发者的每一次模型调用,都在为微软的这套分发网络积累不可替代性。
原文:InfoQ
Hermes Desktop一键本地装机:Nous Research降低开源推理门槛
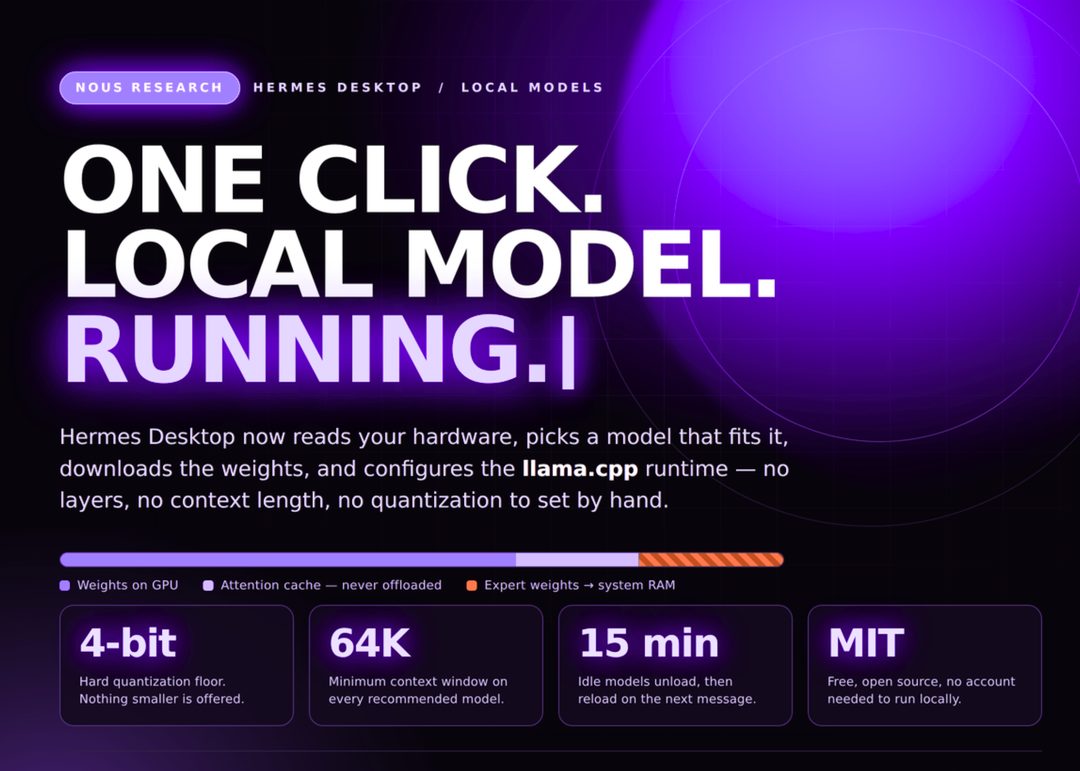
Nous Research为Hermes Desktop加入一键本地模型安装,系统根据硬件自动匹配并下载模型,完成llama.cpp配置,将原本复杂的手动流程压缩为一步操作。
一体化部署省去的不仅是macOS/Windows的使用门槛,更是开源社区“安装即劝退”的尴尬。无需翻文档、无需手搓配置,这意味着从API到本地的每一次调用都免去了外部依赖——数据不出门,体验不断网。
为什么重要:本地模型安装的傻瓜化,将催化两类用户:对数据隐私敏感的团队与离线办公场景的开发者。谁拥有“自动化适配硬件”的抽象能力,谁就更有可能占据本地推理的桌面入口。
原文:MarkTechPost
今天的共性是:AI正在从能力竞赛走向分发权益的争夺——无论是GitHub的多模型路由、微软的算力分布,还是本地模型的一键安装,基础设施层都在想办法让开发者更顺手地调取智能。留给你的问题是:当每一个工作流都能自动选到最合适的模型,你的产品差异还剩下什么?
💭 行业观点
⚙️ 开源工具
当 Anthropic 把 Agent Skills 规范开源、NVIDIA 转头就送上安全扫描器,这个板块正在从“单点工具”走向“生态基建”。今天最值得关注的不是某一个模型跑得多快,而是开源的 AI Agent 供应链——从标准、验收到训练平台——在同一天集体补位。
FreeToken:RTX 4060 跑 35B 模型,消费级推理再进一步
UC Berkeley 与 MIT 联合开源的 FreeToken 宣称可在 RTX 4060 上以约 39 Token/秒的速度运行 35B 参数模型。相比同类方案动辄需要 24GB 以上显存,FreeToken 在显存优化上做文章,把旗舰模型的本地推理门槛拉到了主流甜品卡区间。
关键点在于:它不是量化妥协,而是在推理路径上做显存调度优化。39 Token/秒对交互式对话勉强可用,对批量任务则相当从容。消费级显卡跑 35B 不再是“能跑但没法用”。
对大模型本地化部署而言,硬件墙是比算法墙更现实的瓶颈。FreeToken 如果真如论文所示具备泛化性,将直接扩大开源模型的端侧应用场景——从个人助手到离线分析,都值得重新算一笔账。
原文:InfoQ
Anthropic 开源 Agent Skills 官方仓库:Claude 技能有了标准形态
Anthropic 正式公开 Agent Skills 公共仓库,提供 Claude 技能的标准定义与参考实现。开发者可以将可复用的指令、工具调用链与工作流打包为“技能”,在 Claude Code 及其他支持 agentic 模式的环境中直接挂载使用。
这个仓库的价值不在于代码量,而在于它定义了技能的目录结构、描述格式与调用约定——相当于给 AI Agent 生态补上了一层“包管理规范”。此前各家 agent 的能力复用基本靠复制提示词,现在有了官方参考模板。
Agent 开发正在从“写 prompt”演进到“组装技能”。Anthropic 作为头部模型厂商主动制定这一层标准,意图显然是抢占开发者心智。开源的另一个好处是:社区贡献的技能反过来也在为 Claude 生态做数据飞轮。
原文:GitHub
NVIDIA 开源 SkillSpector:给 Agent 技能做安全体检
就在 Anthropic 发布 Agent Skills 之后,NVIDIA 释出了 SkillSpector——一个专门扫描 Claude Code、Codex 及 MCP 技能的安全工具。它检测提示注入、数据外泄风险和供应链攻击面,能在技能安装前给出“体检报告”。
技能生态的爆发必然伴随投毒风险。恶意技能可能藏在看似正常的指令里,诱导 agent 输出敏感数据或执行危险操作。SkillSpector 的切入点正是这个新兴攻击面:把技能当作第三方依赖来审计。
这标志着 Agent 安全开始从“模型行为对齐”走向“供应链治理”。当技能市场出现,安全扫描就是基础设施,不是可选项。NVIDIA 这步棋,既补了生态缺口,也给自己在 Agent 开发工具链上占了个位置。
原文:GitHub
UC Berkeley 发布 CUA-Lite:computer-use agent 的统一训练场
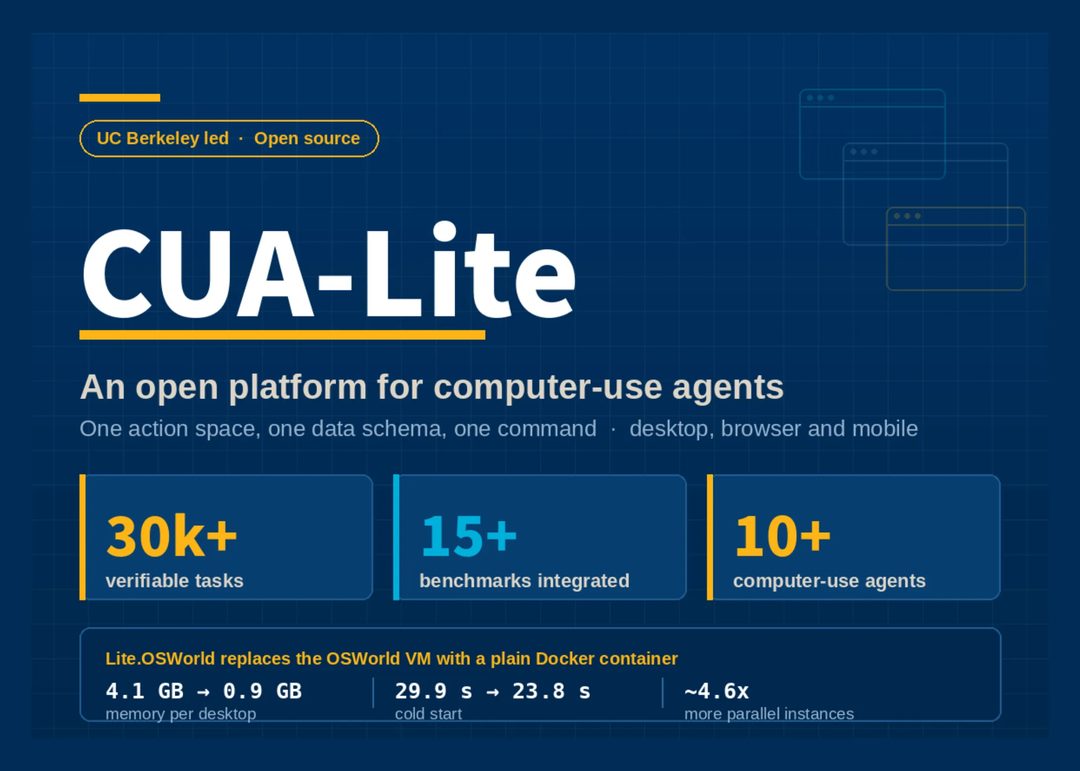
CUA-Lite 将沙箱环境、数据集、评测基准和强化学习框架整合进一个开源平台,目标是让 computer-use agent(能操作电脑完成任务的智能体)的训练与对比不再各自为政。研究者无需自行搭建 GUI 环境或拼接评测管线。
computer-use agent 的痛点从来不是模型结构,而是数据与评测的碎片化。CUA-Lite 这类平台的意义在于:它提供了统一的“度量衡”,让不同 agent 在同等条件下被比较,也让训练数据可以标准化地共享和迭代。
当 agent 开始操作真实软件界面,安全沙箱和可复现评测就变成了行业公共品。这个平台如果被学术界和工业界采纳,会显著压缩 computer-use agent 从论文到产品的周期。
原文:MarkTechPost
Nous Research 开源 hermes-agent:主打个人化成长的智能体
Nous Research 发布 hermes-agent 开源仓库,核心定位是“随用户使用持续演进”的个人化 agent。它会记录交互反馈、调整行为偏好,在长周期使用中逼近用户个人工作习惯——你可以把它理解为一个越用越懂你的本地智能体。
个人化 agent 此前的挑战在于长期记忆和持续学习还停留在论文阶段。hermes-agent 选择直接开源实现,让社区可以直接使用和二次开发。Nous Research 在开源社区的号召力意味着它有机会快速积累真实使用数据。
通用 agent 拼的是能力上限,个人化 agent 拼的是陪伴深度。一旦“越用越懂你”形成体验壁垒,转换成本会非常高。这条赛道上,开源先发者的优势不容小觑。
原文:GitHub
opencode 登趋势榜:自托管编码 Agent 需求仍在爬坡
开源编码智能体 opencode 在 GitHub Trending 上热度上升。作为可自托管的编程助手,opencode 直接对标 Copilot 类的闭源产品,让开发团队把代码补全和 agentic 编程能力部署在自己的基础设施内。
代码数据是很多企业不愿外送的核心资产。opencode 这类工具的持续走热说明:开发者对“代码助手用自己的数据训练”这件事的诉求,不是小众偏好,而是结构性需求。
编码 agent 的竞争正在从“模型能力”转向“工作流整合”。opencode 的热度验证了自托管路线的市场空间,但能否在插件生态和 IDE 体验上追平商业产品,是它接下来要过的关。
原文:GitHub
VoiceStudio:本地运行的开源 ElevenLabs 替代品
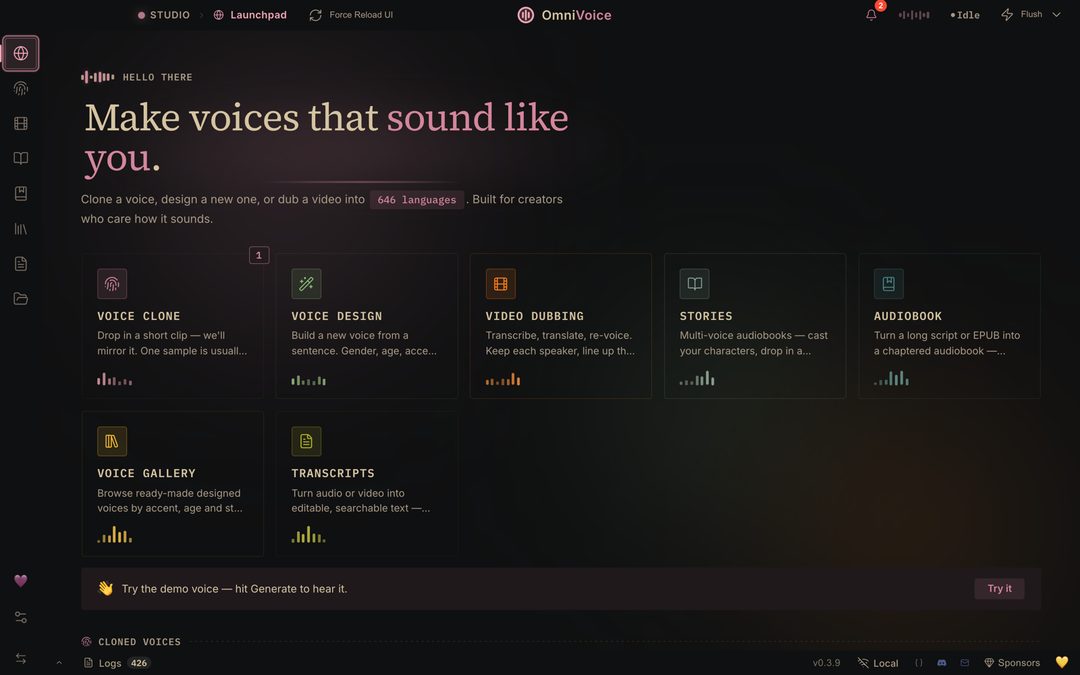
VoiceStudio 是一个可完全本地运行的开源语音工具包,支持语音克隆、声音设计、视频配音与转录,覆盖 646 种语言。对隐私敏感或需要大批量配音的用户来说,它提供了不依赖云 API 的另一种选择。
本地运行意味着零推理费用和数据不出域。646 种语言的覆盖面也让它不只是“玩具级”替代品,而是一个有实际生产力的工具集。语音克隆的伦理风险也让开源社区多了一份责任——好在代码公开意味着监管和审计也能跟上。
语音赛道长期被闭源 API 主导,VoiceStudio 这类项目正在把“配音权”还给用户。成本结构改变会催生新的应用形态:播客本地化、视频二创、无障碍阅读都能以更低门槛落地。
原文:GitHub
OmniVoice:600+ 语言的高质量语音克隆 TTS
OmniVoice 同样是主打多语言的语音克隆与合成系统,覆盖 600 多种语言。与 VoiceStudio 偏工具链不同,OmniVoice 更侧重 TTS 模型的训练与推理能力,目标是把小语种语音合成成本拉下来。
大型语言模型对小语种的文本支持已经不错,但语音侧一直是洼地。OmniVoice 这类开源项目出现,意味着小语种内容创作者不必再等商业公司“排期”支持自己的语言。
两个语音项目同日上榜,指向同一个趋势:语音正在从“封闭 API”走向“开源可训练”。当合成质量跨过可用线,多语言音频内容的生产成本会直线下降——这是内容出海和本地化服务可以立刻利用的变量。
原文:GitHub
Agent 的“技能—体检—训练—发行”闭环在今天一天之内被开源项目补齐了四块拼图。接下来值得追问的是:当技能可以像 pip install 一样安装,谁会先造出那个中毒的包?
原文汇总:FreeToken · Agent Skills · SkillSpector · CUA-Lite · hermes-agent · opencode · VoiceStudio · OmniVoice