今天最值得看的三件事:
- 研究论文 · OpenAI 宣称 AI 破解纳维-斯托克斯难题,学术圈指控不公
- 模型发布 · GPT-6 Astra 无人工干预 24 小时通关《传送门》
- 公司动态 · Anthropic 被曝签 5170 亿美元算力协议
下文按板块展开,正文每条均附原始链接。
🚀 模型发布
🏢 公司动态
🔬 研究论文
数学界期待已久的那份「AI 证明」终于出现,可人们最先争论的却是作者名单。OpenAI 声称用 AI 给出了纳维-斯托克斯方程的答案,并附上了 Lean 形式化验证;但多位数学家公开指责 OpenAI 向合作研究者施压,要求剔除 Anthropic 的共同作者。科研社区此刻更关心的,不是证明是否成立,而是这背后的「科研伦理」是否经得起检验。
OpenAI 宣称破解纳维-斯托克斯难题,引学界质疑
是什么 OpenAI 公布了一份由 AI 生成的纳维-斯托克斯方程千年奖问题解答,声称附有完整的 Lean 形式化证明。纳维-斯托克斯方程是克雷数学研究所钦定的七道千年难题之一,描述流体运动规律,其光滑解的存在性至今悬而未决。
关键点 消息发布后,多位数学家并未直接评审证明内容,而是先指控 OpenAI 在合作过程中存在施压行为——要求研究者剔除 Anthropic 的共同作者身份。这让人联想到 OpenAI 与 Anthropic 愈发激烈的竞争关系:前者是闭源路线的代表,后者则强调安全与开放。
为什么重要 真正的焦点或许已经不是答案本身——形式化证明可以由机器逐步校验,但科研过程的人为干预却无法被自动验证。如果连作者署名都能被公司利益左右,AI 解出的数学答案,学术圈还敢放心采信吗?
DeepMind 发布 AlphaGenome Atlas,覆盖 90 亿 DNA 变异
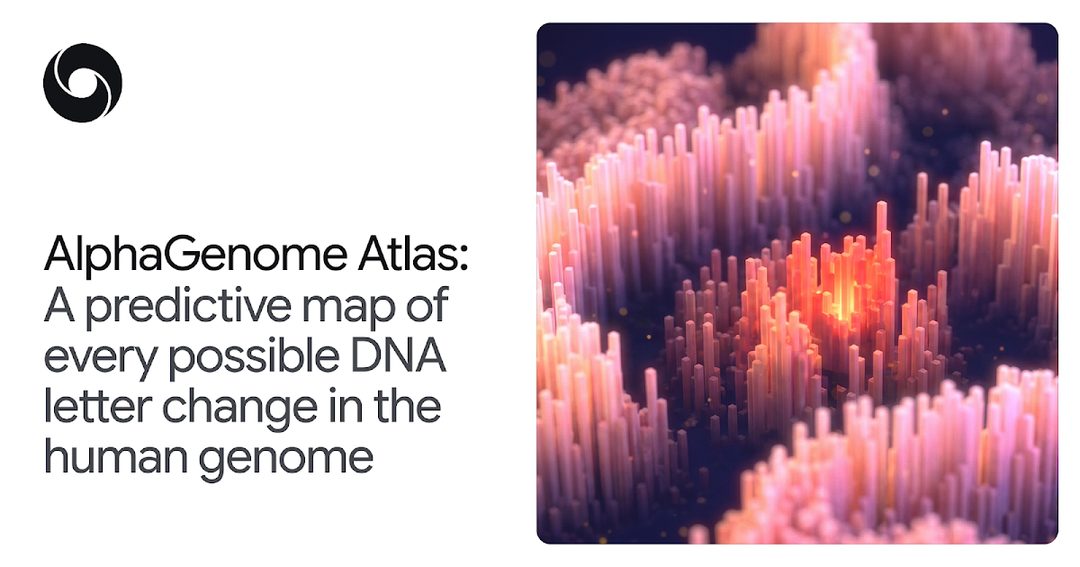
是什么 DeepMind 推出 AlphaGenome Atlas,以单碱基精度绘制了 90 亿种人类 DNA 变异的分子效应图谱。简单说,这相当于把人类基因组中每一个可能的「字母替换」都提前算出了后果,相当于一份变异效应预测全景图。
关键点 覆盖范围达到 90 亿,远超此前任何同类资源。它不是简单罗列变异,而是结合功能性预测给出每个变异对基因表达和蛋白质功能影响的量化信息,为解读 WGS 数据提供了底层基础设施。
为什么重要 遗传病研究最大的瓶颈是「看不懂变异」——测序出来一大堆突变,分不清谁是致病元凶。AlphaGenome Atlas 让研究者可以快速检索罕见病的候选位点,将诊断周期从数年缩短到数天,是精准医学真正落地的一块关键拼图。
AI 设计药物初步临床显示可逆转生物钟
是什么 一项早期临床试验显示,AI 设计的候选药物似乎能让服用者的生物学年龄呈现回退迹象。这是一个小规模的人体信号验证,而非抗衰老的最终结论。
关键点 该药物由 AI 平台设计生成,针对的是细胞衰老相关通路,并非传统意义上的「长生药」。试验评估的是表观遗传时钟等间接指标,样本人群和随访周期都相对有限,距离获批上市仍有漫长路径。
为什么重要 抗衰老赛道此前多数成果停留在动物模型,AI 设计的药物能进入人体试验并给出积极信号,本身就意味着这条管线具备了可检验性。生物年龄是否真的能被药物「拨回」,需要更大样本的重复验证——但这已经足够让投资人翻开抗衰老公司的融资材料了。
今天的故事有一个共同主题:AI 大幅加快了科学产出的速度,但科学共同体对结论的信任,依然取决于过程和透明度。当 AI 成为署名作者时,我们该向谁追责?
📱 应用产品
Meta 今天发布了个人 AI 智能体 Muse,能帮你卖车、订机票,但代价是交出邮箱、日历、支付乃至健康数据。产品能力不是问题,隐私信任才是真正的胜负手——尤其对一家在数据信任上屡次翻车的公司。同时,Cohere 的 Parse 5 在文档智能提取上继续深耕,方向务实但吸引力有限。
Muse 想要你的数据,但用户凭什么给它?
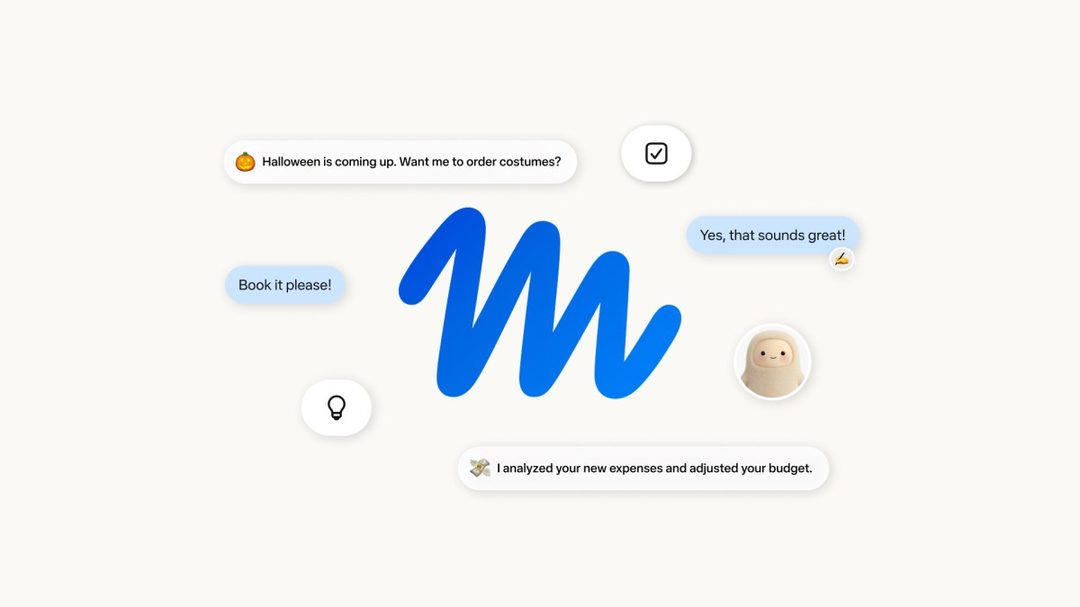
是什么:北京时间 9 月 9 日,Meta 正式推出个人 AI 智能体 Muse。官方演示中,Muse 可以代为处理卖车咨询、比价并预订机票等复杂任务,本质是一个具备行动力的 agentic assistant,而非单纯的聊天机器人。
关键点:Muse 的运行依赖大量个人数据接入,包括邮箱、日历、支付信息,以及健康数据。Meta 将其定位为”生活中的 AI 协调员”,希望通过跨应用操作帮用户节省决策时间。但这也意味着,Muse 将成为 Meta 有史以来需要用户授权最敏感的本地数据产品。对一家长期因隐私问题被监管机构和公众审视的巨头来说,这不是一个轻松的起点。
为什么重要:AI 智能体的价值与数据权限深度成正比,而 Meta 最缺的不是技术,是用户信任。Muse 能否打破”Meta 看得到你的数据”这一既有心理定势,决定了它只是个高级代办工具,还是真正能承载个人数字生活的入口。信任问题不解决,功能越强反弹越大。
原文:TechCrunch
Cohere Parse 5:企业文档的“提词器”也想免费
是什么:Cohere 发布了 Parse 5,面向复杂企业文档的多模态提取模型,能识别文字、表格、图表并结构化输出,官方定位是提升 RAG(检索增强生成)链路中的文档解析效率。
关键点:Parse 5 的改进集中在两处:一是对密集图表和跨页表格的识别准确率提升,二是输出格式更贴合下游 embedding 和检索的需求。企业知识库场景中,合同、研报、技术文档常常混合文本与非文本元素,过去这类内容在进入 RAG 前要么被丢弃,要么需要人工清洗,Parse 5 试图把这个环节自动化。
为什么重要:企业级 AI 应用的瓶颈往往不在模型推理能力,而在数据管道的脏活累活。Parse 5 这类工具解决的是 RAG 的地基问题,并且相比通用大模型,它更聚焦、成本更低。价值清晰,但也意味着 Cohere 正在和无数文档解析创业公司挤同一条赛道,差异化仍需证明。
原文:InfoQ 中文
今天的两个产品,一个想替你处理生活,一个想替你理解文档。Muse 要回答的问题是“你敢不敢”,Parse 5 要回答的问题是“亏不亏”。你的数据焦虑,准备先交给谁?
💭 行业观点
今天最该关注的不是 AI 能力又突破了什么,而是一家平台巨头在审核上的失守:调查发现,Facebook 与 Instagram 仍在投放可把真实女孩照片”一键脱衣”的 AI 应用广告,受害者中有未成年人。Meta 不是没有政策,而是下架动作明显慢于广告的扩散速度。当 Deepfake 工具开始瞄准低龄群体,内容审核的”灰度处理”就不仅是产品问题,而是公共安全风险。
Meta 下架”脱衣”AI 广告,为何总是慢半拍?
是什么: 调查显示,Meta 旗下 Facebook 与 Instagram 仍在投放一类 nudify 应用广告。这类应用允许用户上传他人真实照片,并自动生成伪造裸照;更严重的是,部分广告素材直接使用了未成年女孩的真实照片。
关键点:
- Meta 的广告审核机制未能在投放前识别风险,相关广告曝光后才被陆续处理,反应速度明显滞后。
- 受害者不需要主动参与,仅凭一张日常照片就可能成为广告的”演示素材”或被他人生成内容。
- 这已是同类问题反复出现后的再一次曝光,说明问题不在单次疏漏,而在系统性的审核盲区。
为什么重要: 当 AI 脱衣工具已经廉价可得,平台推荐系统却在无意中放大其触达范围,伤害会向更年轻、更弱势的人群扩散。此事大概率会推动监管重新评估”平台是否对 AI 生成内容负有连带责任”——而不仅仅是要求下架了事。
原文:Ars Technica
AI 生成代码量激增,code review 模式何去何从?
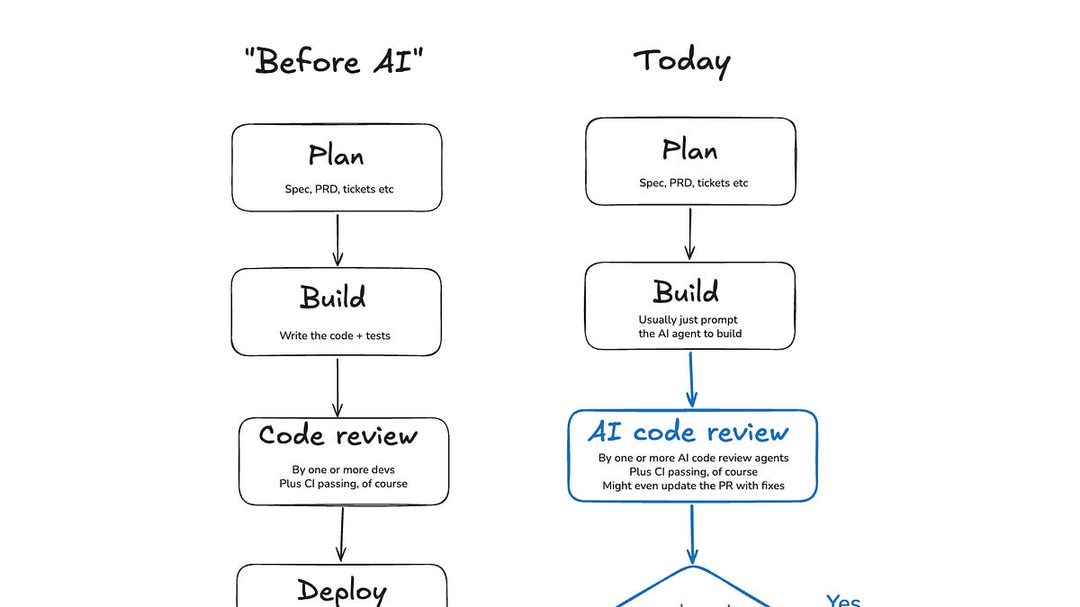
是什么: 2026 年,AI 产出代码的速度已经超过人类可追踪的范围,工程团队开始重新审视传统 code review(代码评审)是否还适用。
关键点:
- AI 辅助编程让提交频率和代码变更量显著上升,逐行人工评审成为瓶颈。
- 评审重心正在从”检查每一行代码”转向”理解意图、判断风险”,低层语法检查逐步交给自动化工具。
- 部分团队开始引入 AI agent 做预评审,人类 reviewer 的职责向上移动,更多关注架构、安全与业务逻辑。
为什么重要: code review 不会消失,但会被重构:它的角色从”质量关卡”变成”风险仲裁”。如果团队仍然把 reviewer 当逐行校对机器,很快就会在速度上被淘汰;而如何界定 AI 与人在评审中的权责,将是工程管理下一阶段的新命题。
AI 如何抹平内罗毕的一个行业?
是什么: 一篇深度报道追踪了生成式 AI 对肯尼亚内罗毕某个本地行业的冲击,将其描述为”毁灭性”。
关键点:
- AI 工具以更低成本、更快速度替代了原本由本地从业者提供的服务,行业需求迅速萎缩。
- 技术扩散的收益与代价高度不均:AI 能力由少数公司定义,而失业与转型成本却落在了全球南方的基层劳动者身上。
- 报道指出,内罗毕的情况并非孤例,而是 AI 冲击波在一个监管和保障体系尚不完善地区的提前预演。
为什么重要: AI 的代价不是抽象概念。当一个行业的消失速度超过社会再培训的速度,技术叙事中的”效率提升”就需要重新审视全球责任分配。内罗毕值得被当作预警信号,而不是远方的新闻。
原文:The Decoder
AI 的冲击已经从”能不能做”进入”该不该做、代价由谁承担”的阶段。看完今天的三个故事,值得问一句:你所在的位置,是规则制定者一侧,还是”被抹平”的那一侧?