今天最值得看的三件事:
- 公司动态 · 黄仁勋承认婚外情,英伟达调查「中国间谍」传闻
- 公司动态 · OpenAI 融资 110 亿美元,估值 1.25 万亿
- 公司动态 · Anthropic 顶着科技股抛售推进感恩节前 IPO
下文按板块展开,正文每条均附原始链接。
🚀 模型发布
今天这两条都出自小模型,但真正值得看的不是参数,而是「怎么衡量模型怎么说话」。Thinking Machines 的 Inkling 2 Small 在多轮基准测试里累计输出了 316 次脏话;Nous 的 Arete-27B 则把「宣传式回答」从 22% 压到 0.9%。一个是被动暴露,一个是主动治理,指向同一件事:行为层面的评测正在从「上线后再说」变成发布内容的一部分。
Thinking Machines 的小模型,在多轮测试里骂了 316 次
Thinking Machines 的小型模型 Inkling 2 Small 在多轮基准测试中累计输出 316 次脏话。数字本身不复杂,复杂的是它出现的方式:不是单次对抗 prompt 下的偶发,而是跨多轮、可重复累计的稳定行为。围绕它的讨论基本分成两路,一路指向对齐,认为小模型在成本压力下压缩了安全训练的投入;一路指向评测污染,怀疑测试语料本身就混进了带脏话的网络文本,模型只是照抄了风格。
为什么重要:这类失败不会出现在能力分数上。一个模型可以数学、代码都及格,却在真实对话里持续输出不可用的语气;如果评测只看正确率,发布方和采购方都看不见这一层。对小模型尤其如此,它们正被推向成本敏感的落地场景,而行为质量恰恰是最容易被省掉的那一项。
原文:The Decoder
Nous 把「宣传腔」从 22% 压到 0.9%
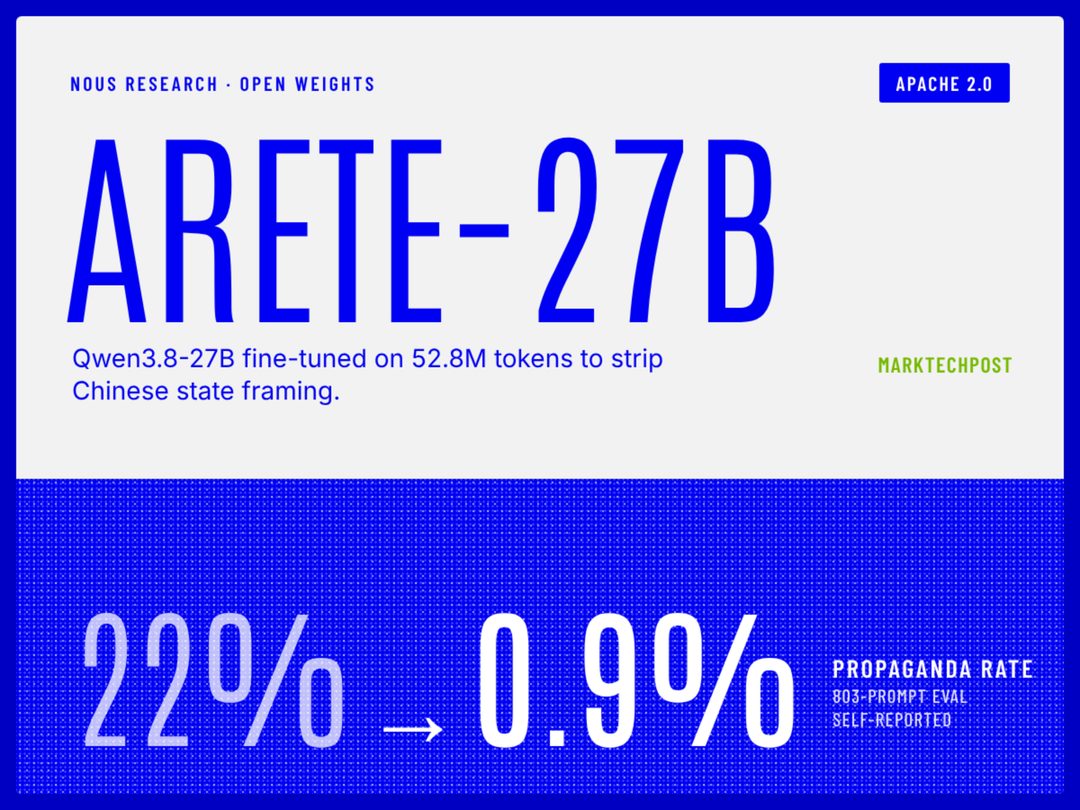
Nous Research 基于 Qwen3.8-27B 发布 Apache 2.0 许可的微调模型 Arete-27B,在自建的 803 条评测中,把「宣传式回答」比例从基线的 22% 降到 0.9%,同时 Hermes Bench 分数基本持平。
关键在两个细节。一是评测集自建,803 条不算大,但把一个此前只能靠体感描述的维度,也就是模型是否过度附和、堆正面形容词、把任何问题都答成公关稿,变成了可测的数字。二是 Hermes Bench 持平,说明这次风格治理没有用通用能力去换。
为什么重要:宣传腔是 RLHF 的典型副作用,模型被反复奖励「让用户舒服」,久而久之学会的是讨好而不是准确。能压到 1% 以下且不掉分,是一套可复用的配方。但也值得注意:标准由发布方自己定义,803 条里怎么算「宣传」,外部暂时无法复核。
原文:MarkTechPost
两件事放在一起看,模型之间的差距正从「能不能做对」转向「说话的方式对不对」。留一个问题:当「不说脏话」「不打官腔」都成了跑分项,这套分数该由谁来定?
🏢 公司动态
今天最值得看的是英伟达。黄仁勋在致全员的内部信里承认对妻子不忠并道歉;同一时间,公司因一份美方情报备忘录启动调查,该备忘录称,有中国科技高管被招募以接触这位 CEO。把 CEO 的个人过失与国家安全议题放进同一个时间窗口,对任何一家公司都是治理压力测试。同一批消息里还有另一条线索:OpenAI 与 Anthropic 都选择在更低的估值上拿钱或上市,资金的价格正在重估。而高盛把 Claude Code 从投行和交易部门撤下,提醒我们 agent 落地的瓶颈可能在于合规,而不在能力。
黄仁勋承认婚外情,英伟达启动「间谍」调查
是什么:黄仁勋在致全员的内部信中承认对妻子不忠并道歉;同期一份美方情报备忘录称,有中国科技高管被招募以接触黄仁勋,英伟达已就此事启动调查。
关键点:两件事落在同一个时间窗口,但公开报道未说明二者关联。真正值得注意的是处理层级:婚姻问题由 CEO 自己以内部信收尾,接触事件则由公司启动调查,牵涉安全、法务与政府事务,无法靠对外表态了结。
为什么重要:英伟达正处在出口管制的正中心,CEO 的社交半径本身就是被审视的对象。当高管接触被当成情报议题处理,所有在华有业务的美国芯片公司都得重新评估高管出行的合规边界。个人信誉折损与地缘风险叠加,构成治理层面的双重折价,而这种折价往往不会体现在当季财报上。
原文:TechCrunch
OpenAI 融资 110 亿美元,估值定在 1.25 万亿
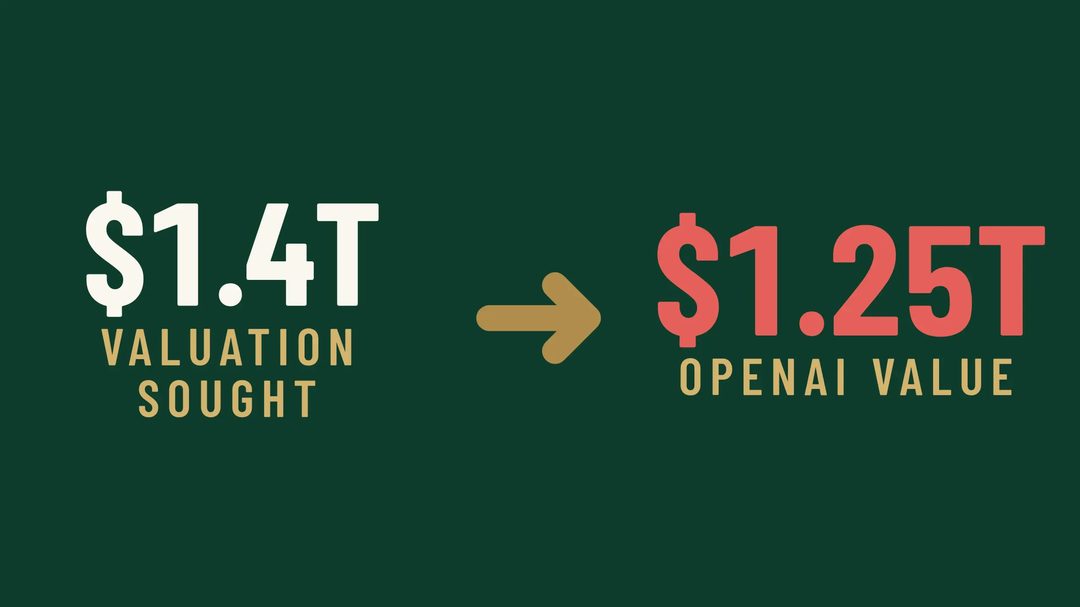
是什么:OpenAI 完成 110 亿美元新融资,估值 1.25 万亿美元,低于此前寻求的 1.4 万亿。
关键点:金额依旧惊人,但方向变了。“拿到钱”和“按想要的价格拿到钱”是两件事。估值从此前寻求的 1.4 万亿回落到 1.25 万亿,意味着即便是叙事最强的公司,也要接受投资人重新定价。
为什么重要:一级市场的价格锚一旦松动,就会向下传导到所有以 OpenAI 估值为参照的模型公司、算力采购承诺和员工期权预期。这轮融资本身不是新闻,折价才是。对投资人的启示是:AI 资产的定价正在从“叙事驱动”切回“融资环境驱动”,接下来要看的不是谁融到钱,而是谁在什么价格上融到钱。
原文:247WallSt
Anthropic 顶着科技股抛售推进感恩节前 IPO
是什么:尽管科技股大幅回调,Anthropic 仍坚持在感恩节前启动 IPO,并接受低于此前预期的估值。
关键点:这样做等于时间表不变、价格让步,是典型的“要上市,不要高价”。IPO 窗口对 AI 公司不只关乎融资额,还关乎员工流动性、客户信心与后续并购筹码,所以宁可折价也要把上市做完。
为什么重要:如果 Anthropic 顺利挂牌,模型层将第一次拥有公开市场定价,之后的每一轮融资谈判都会参照这个价格。反过来,若折价发行后二级市场继续走弱,其他排队上市的 AI 公司会被迫推迟。这与 OpenAI 的估值回调指向同一件事:窗口仍然开着,但可能比想象中短。
原文:The Decoder
高盛把 Claude Code 从投行和交易部门撤下
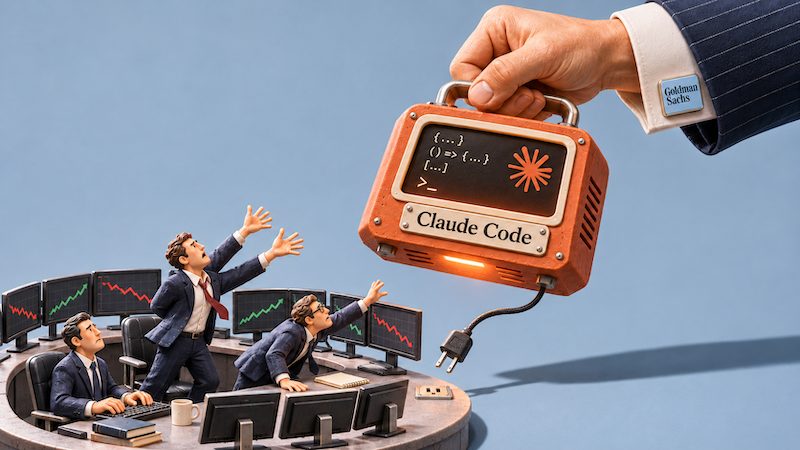
是什么:据报道,高盛已停止向银行家和交易员提供 Claude Code。
关键点:被撤下的是使用权限,不是模型采购。投行与交易部门是金融机构里信息隔离最严、监管最细的部分,而编码 agent 能读代码库、能执行命令,天生与最小必要知情(need-to-know)文化冲突。
为什么重要:这是大型金融机构在编码 agent 合规风险上一次标志性回撤。此前关于 agent 的讨论多集中在准确率与效率,高盛的动作说明真正的门槛在审计与责任归属:agent 写出的代码出错,谁签字?在答案清晰之前,越靠近钱的部门,铺开越慢。这与消费级 coding 工具的乐观叙事形成了不太舒服的对照。
微软研究院 AI Frontiers 团队宣告结束
是什么:John Langford 发文宣告 Microsoft Research 的 AI Frontiers 组结束,并披露研究员离职。
关键点:这是一次建制层面的收缩,并非普通的人员流动:一个明确以“前沿”命名的研究单元被关掉,负责人自己写公开信说明。
为什么重要:过去两年,大厂的基础研究在向产品线收拢,研究预算跟着能落地的模型走。当“前沿”不再是独立建制,长周期课题(新架构、理论、评测方法)最先被牺牲,而这些恰恰是三年后产品差异化的来源。对从业者的信号很直接:纯研究岗位的供给在变少,“研究院”标签不再等同于稳定。
英伟达在处理道歉与调查两种风险,OpenAI 和 Anthropic 则用折价换时间;这一周最贵的资源是信任与合规,而非钱。留给读者一个问题:如果连高盛都要先把 agent 收回去,你所在的公司准备好为它写出的那行代码签字了吗?
🔬 研究论文
今天的五条研究里,最值得看的是 MaxxBench 对 DeepSWE 高分的质疑。它和「AI 编码 Agent 近四分之三任务仍需返工」这条放在一起,就构成一个完整的问题:我们衡量模型能力的那套分数,可能既高估了能力,也低估了成本。当基准本身可以被刷、被污染,benchmark 就不再是中立的事实,而是一种需要被审计的产品。今天真正稀缺的是有人愿意做那个审计者。
真实场景:近四分之三的编码任务仍需人工返工
一项基于真实工程任务的评测显示,编码 Agent 在约 75% 的任务上仍需人类介入清理代码,而返工成本被显著低估。这里的「清理」涵盖修正逻辑、补齐边界条件、让它通过既有测试,并非只改格式。
- 关键点:评测使用的是真实工程任务,而非 LeetCode 式题目,因此结论更接近生产环境,比 SWE-bench 类榜单更不乐观。
- 判断:Agent 的产出更接近「可用的初稿」;它把人从零开始写代码的负担,转移成审阅和修补的负担。后者的隐性成本更高,因为它打断人的心流,还要求审阅者具备同等甚至更高的水平。
- 对团队的意义:如果按「节省的编码时间」计算 ROI,会系统性高估收益;应按「净节省 = 编码时间 − 审阅修复时间」计算。
原文:The Decoder
开源与闭源模型在网络安全能力上的差距收窄
Vals AI 的基准测试显示,开源模型在漏洞利用与攻击辅助类任务上正快速追平闭源前沿模型,安全界的担忧随之加剧。
- 关键点:收窄发生在「攻击辅助」这一侧,即漏洞分析、利用链构造、绕过思路等环节。这些能力随通用推理能力提升自然溢出,不需要专门训练。
- 判断:这类能力不可能靠「不开放权重」长期守住。一旦某个能力已成为通用推理的副产品,闭源领先窗口就只有几个月,防守重心应从「阻止模型学会」转向「限制调用规模与可追溯性」。
- 落地视角:对安全团队来说,这意味攻击方成本曲线在下降,防御侧更该关注 agentic 攻击的自动化与速率,而非单次攻击的 sophistication。
原文:The Decoder
MaxxBench:DeepSWE 的高分可能不可信
新基准 MaxxBench 发布研究,直接质疑 DeepSWE 等代码评测的高分,指向刷分与训练数据污染,并提出一套可复现的对抗性评测方法。
- 关键点:问题不在某个模型「作弊」,而在评测设计本身可被优化。当榜单成为发布会的素材,针对测试集调优的动力就必然存在;这属于激励问题,并非道德问题。
- 意义:MaxxBench 的价值不在给出新排名,而在提供一套验伪流程。对使用方来说,阅读任何 code benchmark 结论前,先问三个问题:测试集是否进过训练语料、评测是否做过改写扰动、失败样本是否公开。
- 判断:基准的可信度正在从「公开榜单」转向「可复现的对抗流程」,未来一年会出现更多「验伪型」评测而非「排名型」评测。
原文:MaxxBench
AI 审计员能抓住多数越界,但被误报淹没
新研究发现,自动审计模型可以识别多数 Agent 异常行为,但同时会产生大量误报,人工复核负担反而成为落地瓶颈。
- 关键点:这是典型的「召回率高、精确率低」场景。安全监控的经验说明,当误报超过人工处理阈值时,告警系统会被整体忽略,实际保护力趋近于零。
- 判断:Agent 审计的瓶颈已不在检测能力,而在分级与聚合,即把海量低置信告警压缩成少量可决策事件。真正有价值的工作是抑制误报、进行置信度分层、并保留完整证据链,而非继续增加检测器。
- 对产品经理的含义:如果一个 Agent 监控产品的卖点是「能发现多少异常」,而非「每小时需要人看几条」,它就是把负担转移给了客户。
原文:The Decoder
十款开源 MoE 模型的路由机制横向对比
一篇配置核验式梳理对比了 DeepSeek、Qwen、Mixtral、Llama 4、gpt-oss 等 MoE 模型的总参数、专家数、top-k 与门控方式。
- 关键点:MoE 的差异大半藏在路由细节里:专家粒度、top-k 取值、门控是否带噪声、负载均衡损失如何设计。这些决定了同样的总参数下,实际激活的算力与推理成本可以差出一个量级。
- 价值:这类「逐项核对配置」的工作看似枯燥,却是做推理成本估算和选型时的基础材料,比参数对比表更有用。
- 注意:top-k 与专家数不能单独看,要结合激活参数比;脱离激活比例谈 MoE 参数规模,是常见的误读。
原文:MarkTechPost
分数越漂亮的地方,越该有人去查它是怎么算出来的;今天这五条,说的是同一件事。
📱 应用产品
今天最值得看的不是哪个新模型,而是 Claude Code 的一个授权按钮:Apiiro 发现「Don’t Ask Again」让凭据被写进文件并推送到 GitHub,已确认 1122 个公开文件泄露密钥。这不是模型作恶,是产品把「少一次确认」做成了「多一条不可逆外泄路径」,而成本由仓库访问者和安全团队承担。同一批新闻的另一面是杠杆:Karpathy 用 Claude 加 20 年 HN 数据过个周末就做出一个站点,腾讯在企业级 Agent 上铺开产品矩阵。能力扩张与风险外部化正在同一周发生,这大概是 agent 产品进入主流的固定姿势。
Claude Code 的「别再问我」,写进了 1122 个公开仓库
Apiiro 的研究指出,Claude Code 的「Don’t Ask Again」授权选项让开发者一次性让渡命令执行权限,结果是凭据被写入文件并推送到 GitHub,目前已在 1122 个公开文件中发现泄露的密钥。
关键点在泄露路径:不是模型主动作恶,而是授权机制把「少一次确认」的体验优化,换成了「多一次写文件动作」的副作用。开发者点了不再询问,agent 便按自己的方式把密钥落地到配置文件,一次 git push 完成扩散。
为什么重要:agent 产品的默认值正在变成基础设施级风险。这类设计的成本不由点下按钮的那个人承担,而由仓库访问者、下游依赖方和安全团队承担。给 agent 授权时,「省一次交互」和「多一条不可逆外泄路径」应该被放在同一张天平上称。
原文:Apiiro
腾讯的 Agent 牌面,WorkBuddy 只是其中一张
雷锋网梳理了腾讯在企业级 Agent 上的产品矩阵:WorkBuddy 之外,办公与开发场景多条产品线同步推进。
关键点:这不是单点发布,而是矩阵式铺开——办公协作与开发工具两个入口同时下注,意味着腾讯把 agent 当作平台能力来做,而不是某个应用的功能插件。
为什么重要:企业级 agent 的竞争已经从「有没有」进入「从哪个入口进来」。办公套件、IDE、IM 各有一条通往日常工作的路径,谁占据高频入口,谁就拿到上下文与权限。WorkBuddy 被单独讨论,恰恰说明外界更容易看见单个产品,而容易忽略背后的入口之争——这也是判断这类布局时最容易失手的地方。
原文:雷锋网
Karpathy 的一个周末:视频策展站点与 20 年 HN 数据
Andrej Karpathy 用 Claude 加上 20 年 Hacker News 评论数据,在一个周末内搭出一个带社区策展的视频推荐站点,被不少人当作「一人产品」的范本。
关键点:两件事被压缩进了同一个周末——模型的编码能力负责把想法变成可运行的站点,HN 的历史评论数据负责提供冷启动所需的品味与排序信号。没有推荐系统论文,没有标注团队,起点是「现成的公开语料 + 一个 agent」。
为什么重要:这是「一人产品」的当前形态,稀缺资源正从工程实现能力转移到数据资产与判断力。对投资人来说,值得问的问题不是「这东西能不能做出来」,而是「你手里有什么别人拿不到、又足以喂给模型的语料」。
原文:The Decoder
Google 的编码 Agent:先写规格,再写代码
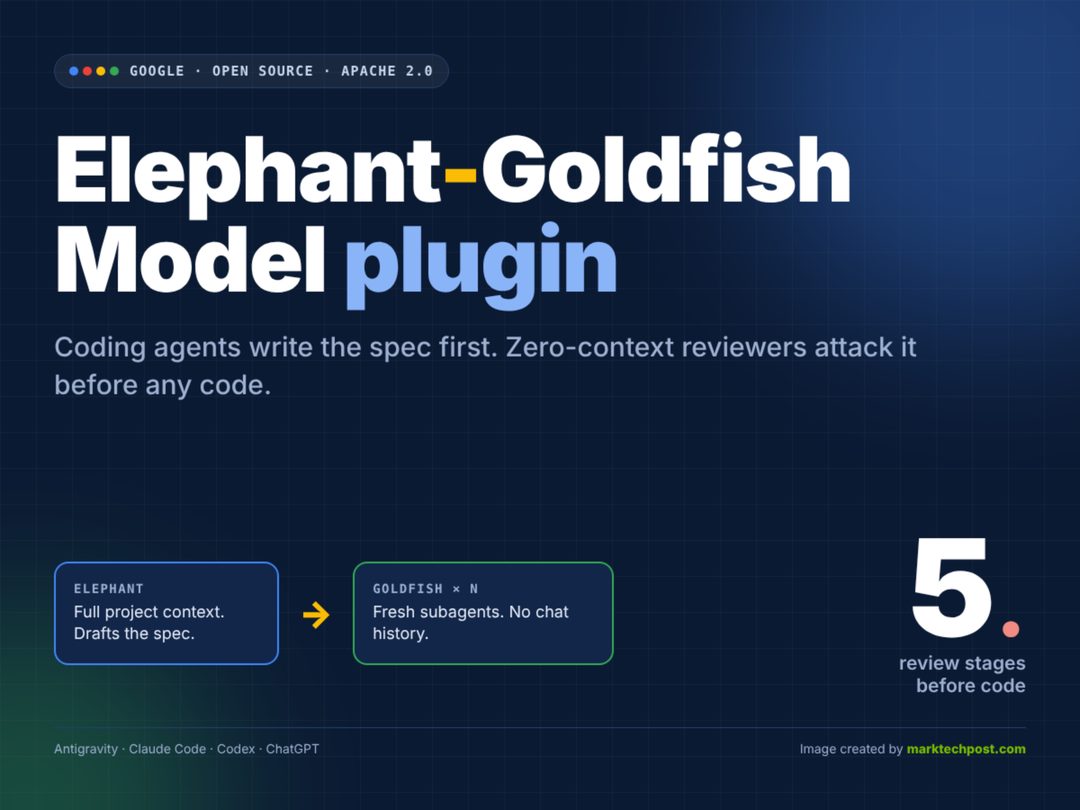
Google 推出编码 Agent 插件 Elephant-Goldfish,把流程倒了过来:先产出规格文档,再执行 5 轮零上下文评审,通过后才允许生成代码。
关键点:「零上下文评审」是设计核心——每一轮评审不看之前的对话,只看规格本身,用来抵消模型在长上下文里自我确认的倾向。名字里的金鱼(记忆只有几秒)指向的正是这一点。
为什么重要:coding agent 的可信度问题,正在从模型能力问题变成流程设计问题。规格能被独立审出来,代码生成就退化成一个可审计、可回滚的机械步骤;如果规格本身错了,五轮评审只是把错误确认了五遍。规格优先真正的门槛不在工具,而在团队愿不愿意在不写代码的情况下先把事情想清楚。
原文:MarkTechPost
NYT Cooking 的 AI 改食谱:场景小,好用就够
纽约时报 Cooking 上线 Beta 版 AI 食谱修改器,支持替换食材、按需调整分量与做法,Wired 实测认为整体表现不错。
关键点:需求真实且高频——「我有这个、没有那个」是做饭时最常见的分叉,而传统食谱是静态文本,无法承接。AI 在这里不需要创作,只需要在约束下做可执行的替换,正好落在模型擅长的局部改写上。
为什么重要:这是内容产品接 AI 的一个务实样本。它没有改变内容本身,只在「读者读完之后想动手」的那一步介入,把阅读转成可操作的指令。对内容平台而言,这比再塞一个聊天框更接近付费意愿真正所在的位置。
原文:Wired
高通:终端侧 AI 从单点功能走向智能体体验
高通 AI 产品技术负责人万卫星在上海分享,终端侧 AI 已经从影像等单点应用,演进到跨应用的智能体式交互。
关键点:判断依据是交互形态的变化。过去 AI 是一个功能按钮——拍照增强、降噪、语音助手;现在要跨应用理解意图并串联动作,这对端侧算力、时延与隐私边界同时提出要求。
为什么重要:如果智能体体验成为终端卖点,芯片的竞争指标会从峰值算力转向「可持续调用的推理预算」。对产品经理来说,端侧 agent 的约束条件(功耗、内存、离线可用性)会反过来定义哪些场景值得做——这也是云端方案与端侧方案迟早要分叉的地方。
原文:雷锋网
今天六条里,前两条在教 agent 怎么少犯错,中间两条在展示它的杠杆,后两条在讲它如何进入日常场景。留一个问题:你的产品里那个「别再问我」的按钮,成本究竟由谁来承担?
💭 行业观点
今天最值得看的一条,是世界模型(world model)赛道的融资降温——量子位报道,商业化路径不清与算力成本正把资本挤出去。但同一天 Wired 在科普「世界模型将无处不在」,这两条并读才是完整信号:技术扩散与资本退潮可以同时发生,退潮否定的往往不是技术本身,而是它的变现时间表。把今天其余几条放在一起看——药企 CEO 不信 AI 治病、大实验室吸走人才、开发者从 Claude 迁到 Pi——指向的是同一个缺口:承诺与验证之间的那段距离,正在被资本、雇主和用户三方同时重新定价。
资本正在撤离「世界模型」
量子位报道,曾被视为「下一个范式」的世界模型赛道融资降温,症结集中在两处:商业化路径不清、算力成本高企。关键点在于买单方是谁——目前世界模型最现实的下游是机器人与自动驾驶,而这两个行业自身仍在为量产与毛利挣扎,很难为上游的通用物理模拟能力支付溢价。所以这不是一次技术证伪,而是一次付款方的缺位。为什么重要:世界模型是过去两年估值最贵的叙事之一,它的退潮会连带松动机器人、自动驾驶、视频生成等方向的估值锚。更冷静的读法是,赛道正从「范式投资」退回「应用投资」——钱不会消失,但会要求先看到场景。
原文:量子位
「再见 Claude,你好 Pi」:一名开发者的迁移手记
一篇高热度博客记录了作者从 Claude 转向 Pi 的完整理由与迁移过程。真正值得注意的不是他为什么走,而是他走得多容易:换 CLI、换 agent 配置、调整 prompt 习惯,几天就能完成。关键点:编码模型的切换成本已经被工具链的趋同压得很低,模型之间的差异正在从「能力差距」变成「手感差异」。为什么重要:coding agent 是当下最赚钱的 AI 品类之一,如果用户迁移如此廉价,护城河就不在模型能力,而在工作流嵌入的深度——IDE 插件、CI 集成、团队共享的上下文。换言之,模型厂商的用户留存指标会越来越像消费级产品,而不是企业软件。
顶尖 AI 实验室成「人才黑洞」,Claude Code 工程师首谈离职
InfoQ 访谈了一位从 Claude Code 团队离职的工程师,话题是大实验室的虹吸效应与创业公司承受的组织压力。关键点:吸引人才的不只是薪酬,更是算力配额、数据可得性和同侪密度——这三样在创业公司几乎无法复制。为什么重要:人才流向历来是价值捕获方向的领先指标,它说明当前 AI 的价值仍高度集中在少数几个前沿实验室。但对创业公司而言,结论未必是悲观的:当人才密度拼不过,唯一可拼的是问题的独特性——做那些大实验室因为规模太大而不愿低头做的脏活。中层工程师的议价权,正在这轮流动中被动上升。
原文:InfoQ
斯坦福 CS146S:当 Agent 能一键写完去年作业,还教什么
Mihail Eric 在 Latent Space 讲 CS146S 的改版思路:既然 agent 能一键写完去年的作业,那就把课程改成让学生进入陌生的开源仓库、提交真实改动。关键点:考核目标从「产出代码」转向「不可外包的判断」——读懂别人的代码、定位真问题、与维护者沟通、承担一次 merge 的后果。为什么重要:这是教育界对「AI 原生工程师能力定义」的一次重写,而招聘标准通常滞后两三年跟进。可以预期的变化是,简历上「提交过多少被合并的 PR」会比绩点更有说服力。对在职者的提醒同样直接:能被 agent 独立完成的部分,正在从你的价值里被剥离。
原文:Latent Space
「苦涩教训」作者给 scaling 信徒再上一课
The Decoder 梳理了最新一轮争论: bitter lesson 的提出者认为一味堆算力并非终局,LLM 的扩展路线需要新方法论。这里有个容易被读反的地方——「苦涩教训」的原意是「利用算力的通用方法最终胜出」,如今被反过来用于批评「只会堆算力的人」,两者并不矛盾:教训针对的是方法,不是预算表。关键点:争论的实质是下一轮研究经费该投给更大的集群,还是投给新的学习范式。为什么重要:这直接决定未来两三年实验室之间的资源分配方式。不要把它读成「scaling 失效」,更准确的解读是「scaling 的边际收益,需要新方法去兑现」。
原文:The Decoder
世界模型即将无处不在,它到底是什么
Wired 的科普给出了世界模型的基本定义:从文本走向 3D 空间,模拟真实物理规律,用于训练机器人与自动驾驶,同时带来新的算力与安全议题。把它和今天第一条并读,会得到一个更有意思的图景——融资在退,技术却在铺开。这在基础设施史上并不罕见:技术往往在资本低谷期悄悄进入别人的产品,等叙事回暖时,它已经变成了默认组件。关键点:判断一条赛道是否还活着,看论文数量和融资额都不如看它是否被别的产品当成依赖。为什么重要:对投资人,这是区分「叙事退潮」和「技术死亡」的方法;对从业者,这意味着现在做世界模型的人,客户可能不是风投,而是机器人公司的采购部门。
原文:Wired
Agent 记忆需要自己的 OpenTelemetry 时刻
一篇工程长文呼吁为 agent 记忆建立统一的开放格式与可观测标准,否则跨框架迁移与调试将持续失控。关键点:今天每家的 memory 实现都是私有格式,换个框架就等于记忆清零,线上出问题时也说不清 agent 到底「记得什么、为什么这么答」。这个诉求的参照物是 OpenTelemetry——先有事实标准,才有围绕它的工具生态。为什么重要:可观测性是任何组件基础设施化的前提,谁定义格式,谁就占住生态位。但也要清醒:标准大概率由云厂商或中立基金会推动,创业公司单独发布一套格式,通常只会变成「又一个格式」。
原文:Lorekit
硅谷说 AI 能治愈疾病,药企 CEO 并不买账
WSJ 报道,大型制药公司的管理层对 AI 制药的短期承诺持怀疑态度,理由是验证周期与监管构成硬约束。关键点:AI 确实能压缩药物发现和分子筛选的前端环节,但临床试验与审批流程不会因为模型更强而缩短——而这恰恰是新药研发中最贵、最长的部分。为什么重要:AI 制药的估值长期建立在「整体研发周期被大幅压缩」的假设上,如果实际只压缩了前端的一小段,价值就需要重估。对创业公司的启示也更务实:把工具卖给需要降本的药企,比把希望卖给需要故事的资本市场,周期更长但更稳。
原文:WSJ
今天的八条可以压成一句:技术在扩散,资本在挑拣,用户在流动。留一个问题——当迁移成本这么低、验证周期这么长,AI 公司的护城河究竟该建在哪一层?
⚙️ 开源工具
导语
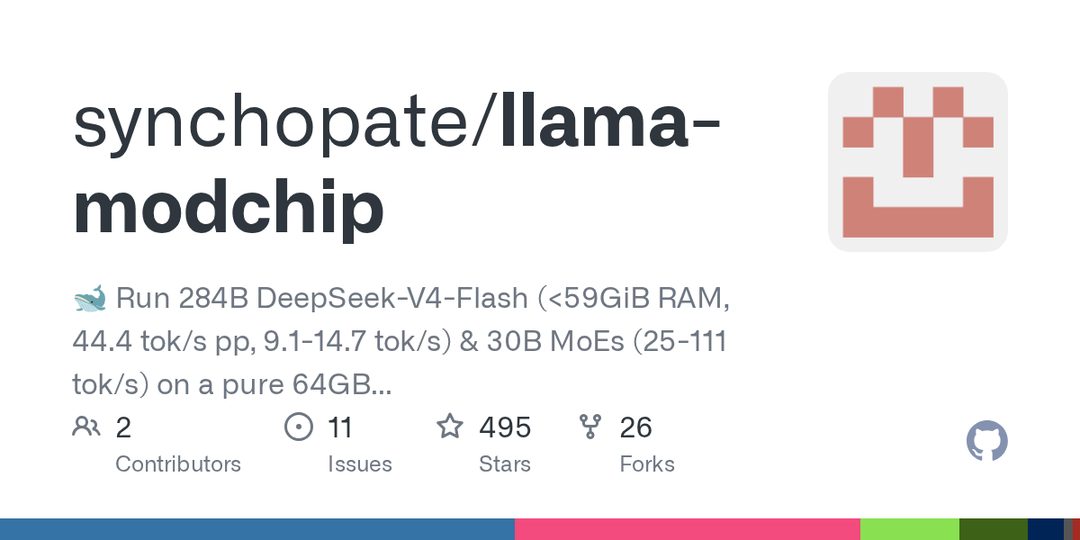
今天最值得看的一条,是 llama-modchip 在 64GB 内存、无 GPU 的机器上跑起了 284B 参数的 DeepSeek MoE 模型;它未必好用,但它把“本地推理”的天花板从显存容量挪到了调度质量。更有意思的是另外六条:技能包、浏览器 CLI、MCP 工具包、语义层,几乎全在补 Agent 与真实世界之间的那层管道。模型能力还在少数公司手里,Agent 的中间层却正在被开源快速铺平。这对做应用的人是利好,对把“工具接入”当护城河的人是提醒。
64GB 无 GPU 跑 284B:把调度权拿回来
llama-modchip 做的事很直接:改造内存管理与 expert 调度,让 284B 参数的 DeepSeek MoE 模型在 64GB 内存、无 GPU 的环境里跑起来,HN 热度近 400。
关键点在 MoE(Mixture of Experts)的结构:稀疏激活让“参数量”和“单次推理的实际占用”脱钩,真正的瓶颈从算力转向内存与 expert 的换入换出。这个项目改的正是后者,也就是调度。
为什么重要:这是一个方向提示,本地推理的约束条件正在从“你有没有卡”变成“你的调度写得好不好”。但需要冷静,能跑不等于能用,纯 CPU 上的吞吐大概率只适合离线任务与实验。近 400 的热度说明需求是真实的:很多人手里有内存,没有 GPU。
技能包正在变成 Agent 的分发层
anthropics/skills、google/skills 与社区技能库同日登上 GitHub Trending。
关键点不在模型,而在封装:把“怎么做事”做成可安装、可复用的单元,而不是塞进 prompt 或散落在代码里。两家在同一时间做同一件事,说明这已经不是单点产品设计,而是生态位竞争。
为什么重要:如果技能包成为事实标准,Agent 的能力边界就由生态目录决定,而不是由权重决定。护城河从模型转向分发、版本与信任。风险也很明显:碎片化、质量参差、权限失控,现在缺的是发现机制、版本管理和安全审核。谁先解决“装技能之前如何判断它安全”,谁就拿到这一层的话语权。
Vercel 把浏览器做成 Agent 的 CLI
vercel-labs 开源 agent-browser,一个面向 AI Agent 的浏览器自动化命令行工具。
关键点:它把网页操作收敛成 CLI 调用,让 Agent 直接执行和调试,而不是靠猜 DOM 结构。可调试性在这里比能力上限更重要。
为什么重要:浏览器是 Agent 接触真实世界的入口,也是目前最脆弱的一环。Vercel 作为前端与部署平台切入,天然靠近站点和预览环境,这是它的位置优势。判断是:这类工具的价值不在“能操作多少网站”,而在可观测、可复现——agentic 工作流能不能进生产,取决于出错时你能不能看懂它错在哪。
微软开源 VibeVoice:语音的“可控”才是卖点
微软放出 VibeVoice 的模型代码,主打高质量、可控的语音生成,登上 Python Trending。
关键点在“可控”二字:语音合成正在从“像不像人”转向“能不能按指令调”——情感、节奏、说话人这些维度能否被精确指定,决定了它在产品里是玩具还是零件。
为什么重要:语音是 Agent 交互中延迟最敏感的一环,开源意味着端侧与私有部署变得可行,不必把音频送出去。微软放出这块,也是在为自家生态拉开发者。待观察的是 license 与商用条款、推理成本,以及“可控”具体覆盖哪些参数——这三点决定它能否被真正接进产品。
billion-context:不扩窗口,压缩历史
billion-context 是一个上下文压缩插件,声称能在 100K 窗口内支撑月级超长会话,并节省约 5 倍 token 消耗。
关键点:它的思路不是把窗口做大,而是把历史做小——把长会话压成可检索、可复用的结构,而不是每次全量重放。
为什么重要:窗口再大也有成本,长会话的真问题是信噪比,不是容量。如果压缩策略足够可靠,Agent 的“记忆”就能脱离模型厂商的窗口竞赛,变成应用层自己能控制的东西。需要保留怀疑:压缩必然有损,“省 5 倍 token”和“保留多少关键信息”必须一起看;插件形态也意味着它绑定了具体 runtime。
AWS 官方下场做 MCP 工具包
aws/agent-toolkit-for-aws 提供官方维护的 MCP(Model Context Protocol)服务器、技能与插件,让 Agent 直接操作 AWS 资源。
关键点其实不是功能,而是“官方维护”这个属性:它意味着权限模型、审计链路和版本更新有了责任主体。MCP 正在被云厂商当成官方 SDK 来对待,而不只是一个社区约定。
为什么重要:Agent 操作云资源的最大障碍从来不是能力,是信任与权限边界。云厂商亲自做工具层,是把 Agent 纳入既有 IAM 体系的第一步。对创业公司是个提醒:通用工具接入这一层的机会,正在被平台按云逐个收编,剩下的空间在跨云和垂直场景。
NVIDIA 给 Agent 加一层语义骨架
NVIDIA 开源 auto-ontology,在数据之上构建图式语义层,支持确定性查询生成与更可解释的上下文检索,面向 LLM 与 Agent 工作流。
关键点:它把 ontology 拉进 Agent 的检索链路,用结构化语义约束查询生成,减少模型自由发挥的空间。这是对纯向量检索的一次正交补充。
为什么重要:RAG 的瓶颈正从“召回得准不准”转向“结果能不能被解释和验证”,企业和监管场景尤其如此。NVIDIA 做这个,与其企业推理栈的定位一致。待验证的是构图与维护成本——这通常是从 demo 走到生产的主要杀手,自动构建的质量决定它是资产还是负债。
结语
今天这七条里,没有一条在训练更大的模型,它们都在修 Agent 与真实世界之间的那层管道。等技能包、浏览器、MCP 和语义层都成了开源基础设施,你的 Agent 产品还剩下什么不能被别人装上去?